


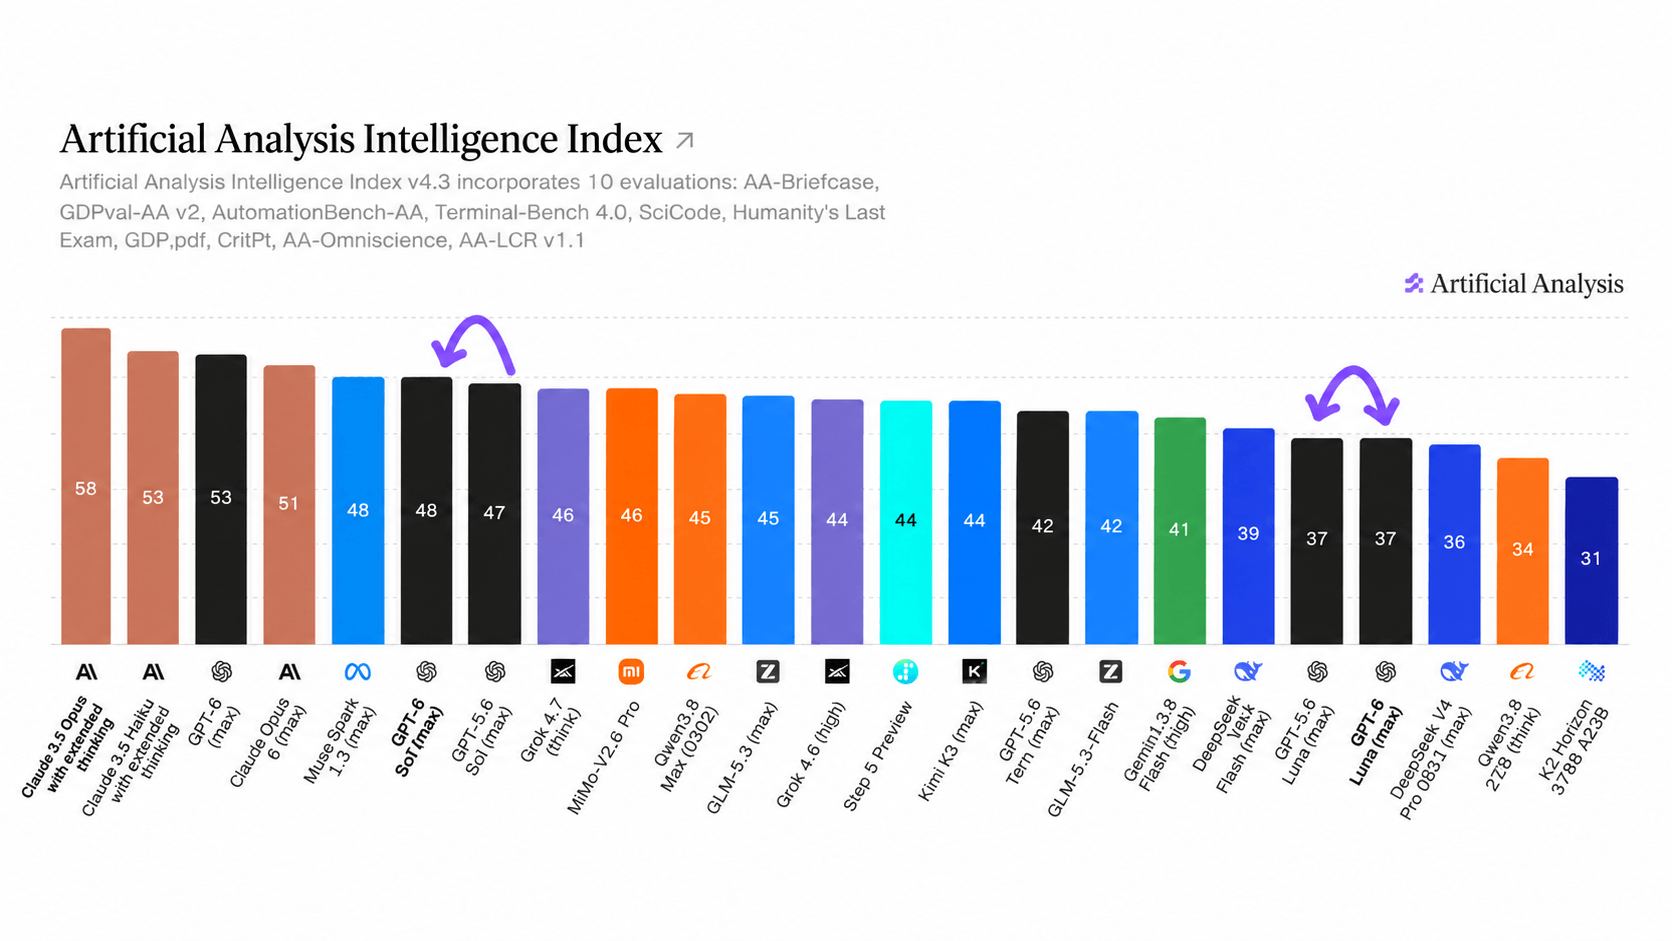
Il 22 settembre OpenAI e Anthropic hanno presentato due mosse parallele sul mercato dell’intelligenza artificiale. Gli annunci sono due, i nuovi modelli sono tre: GPT-6 Sol e GPT-6 Luna per OpenAI, Claude Opus 5.5 per Anthropic. Tutti promettono di ridurre il costo d’uso rispetto ai rispettivi predecessori, pur rivolgendosi a carichi di lavoro molto diversi.
Vediamo che sta succedendo.
Dopo una fase dominata dalla corsa al modello più capace, i due laboratori statunitensi stanno segmentando l’offerta per prezzo, velocità e complessità del compito. È una risposta alla domanda di imprese che devono portare l’AI dai progetti pilota ai processi ricorrenti, ma anche alla pressione dei modelli open-weight, molti dei quali sviluppati in Cina e disponibili a costi bassi o installabili su infrastrutture scelte dal cliente.
Indice degli argomenti
GPT 6 Sol, Luna e Opus 5.5. Tre modelli, due strategie per abbassare il costo
OpenAI colloca GPT-6 Sol un gradino sotto il modello di punta Astra e lo destina al coding complesso e ai flussi agentici. Il prezzo standard dichiarato è di 2 dollari per milione di token in input e 10 dollari per milione in output. GPT-6 Luna è invece il modello per attività focalizzate e ad alto volume, come classificazione, estrazione e sintesi: 0,10 dollari in input e 0,50 in output. Nell’annuncio dei due modelli, l’azienda parla di prezzi API inferiori del 50% rispetto alla tariffazione promozionale della famiglia GPT-5.6.
Anthropic segue una strada diversa. Claude Opus 5.5 resta nella fascia alta e viene proposto per agenti di lunga durata, coding e lavoro professionale complesso. Il listino ufficiale di Claude Opus 5.5 indica 4 dollari per milione di token in input e 20 dollari in output, il 20% in meno rispetto a Opus 5. Anthropic stima però una riduzione del 40% sul costo dei carichi tipici, perché il modello utilizzerebbe meno token per completare il lavoro e le letture dalla cache scendono da 0,50 a 0,20 dollari per milione di token.
Tabella 1 Prezzi standard API in dollari per milione di token
| Modello | Uso indicato dal fornitore | Input per 1M token | Output per 1M token | Posizionamento |
| GPT-6 Sol | Coding complesso e flussi agentici | 2 dollari | 10 dollari | Fascia intermedia della famiglia GPT-6 |
| GPT-6 Luna | Attività focalizzate ad alto volume | 0,10 dollari | 0,50 dollari | Modello più efficiente della famiglia |
| Claude Opus 5.5 | Agenti, coding e lavoro professionale complesso | 4 dollari | 20 dollari | Fascia alta Anthropic con costo ridotto |
| GPT-6 Astra | Compiti di frontiera, usato qui come confronto | 10 dollari | 50 dollari | Modello premium OpenAI |
I prezzi OpenAI sono quelli standard per prompt entro 272.000 token. Contesti più lunghi, modalità di elaborazione diverse, cache e localizzazione regionale modificano il conto. Anche il 40% indicato da Anthropic non è uno sconto uniforme sul listino, ma una stima riferita a carichi tipici. Questa distinzione evita di trasformare percentuali commerciali non omogenee in un confronto diretto.
La distanza tra le fasce resta ampia. In un carico teorico con un milione di token in input e 200.000 in output, senza cache, strumenti esterni o tentativi falliti, Luna costerebbe 0,20 dollari, Sol 4 dollari, Opus 5.5 8 dollari e Astra 20 dollari. Lo stesso processo può quindi avere un costo cento volte diverso a seconda del modello selezionato. La convenienza reale dipende però da quante risposte superano i controlli di qualità e da quanto lavoro umano serve per correggerle.
La pressione degli open-weight ridisegna la gara globale
Il ribasso dei laboratori statunitensi arriva mentre i modelli open-weight guadagnano spazio nelle applicazioni.
Ricordiamo che open-weight significa che i pesi del modello sono scaricabili; non implica automaticamente che codice, dati di addestramento e licenza siano interamente aperti. Per un’impresa offre comunque più possibilità di scelta: esecuzione presso un cloud provider diverso, installazione su infrastruttura propria, adattamento del modello e maggiore controllo sul ciclo di aggiornamento.
L’AI Gateway Production Index di Vercel, basato sul traffico aggregato instradato dalla piattaforma, indicava nei dati relativi a giugno gli open-weight al 29% dei token, contro l’11% di aprile, con meno del 4% della spesa. Il confronto con i dati più recenti richiede però cautela, perché Vercel ha nel frattempo ampliato la classificazione dei modelli open-weight. Nel leaderboard aggiornato al 22 settembre e riferito ai tre mesi precedenti, che classifica i modelli in base alla disponibilità dei pesi, gli open-weight rappresentavano il 77,1% dei token; DeepSeek V4.1 Flash da solo arrivava al 58%.
Quando costo e prestazioni sono sufficienti, il traffico ad alto volume si sposta rapidamente. Nello stesso campione la graduatoria per spesa è molto più distribuita, segno che i modelli premium conservano spazio nei compiti in cui un errore costa più della chiamata API.
La concorrenza cinese agisce sia sul listino sia sull’architettura di mercato. DeepSeek V4.1 Flash offre i pesi con licenza MIT e, tramite API, applica nelle ore di punta 0,30 dollari per milione di token in input non memorizzati in cache e 1,20 dollari in output; nelle ore non di punta le tariffe si dimezzano. Qwen di Alibaba, Kimi di Moonshot AI e altri modelli ampliano ulteriormente la disponibilità di alternative scaricabili o servite da più operatori.
Molti segnali indicano che le aziende sono sempre più sensibili al tema prezzo AI.
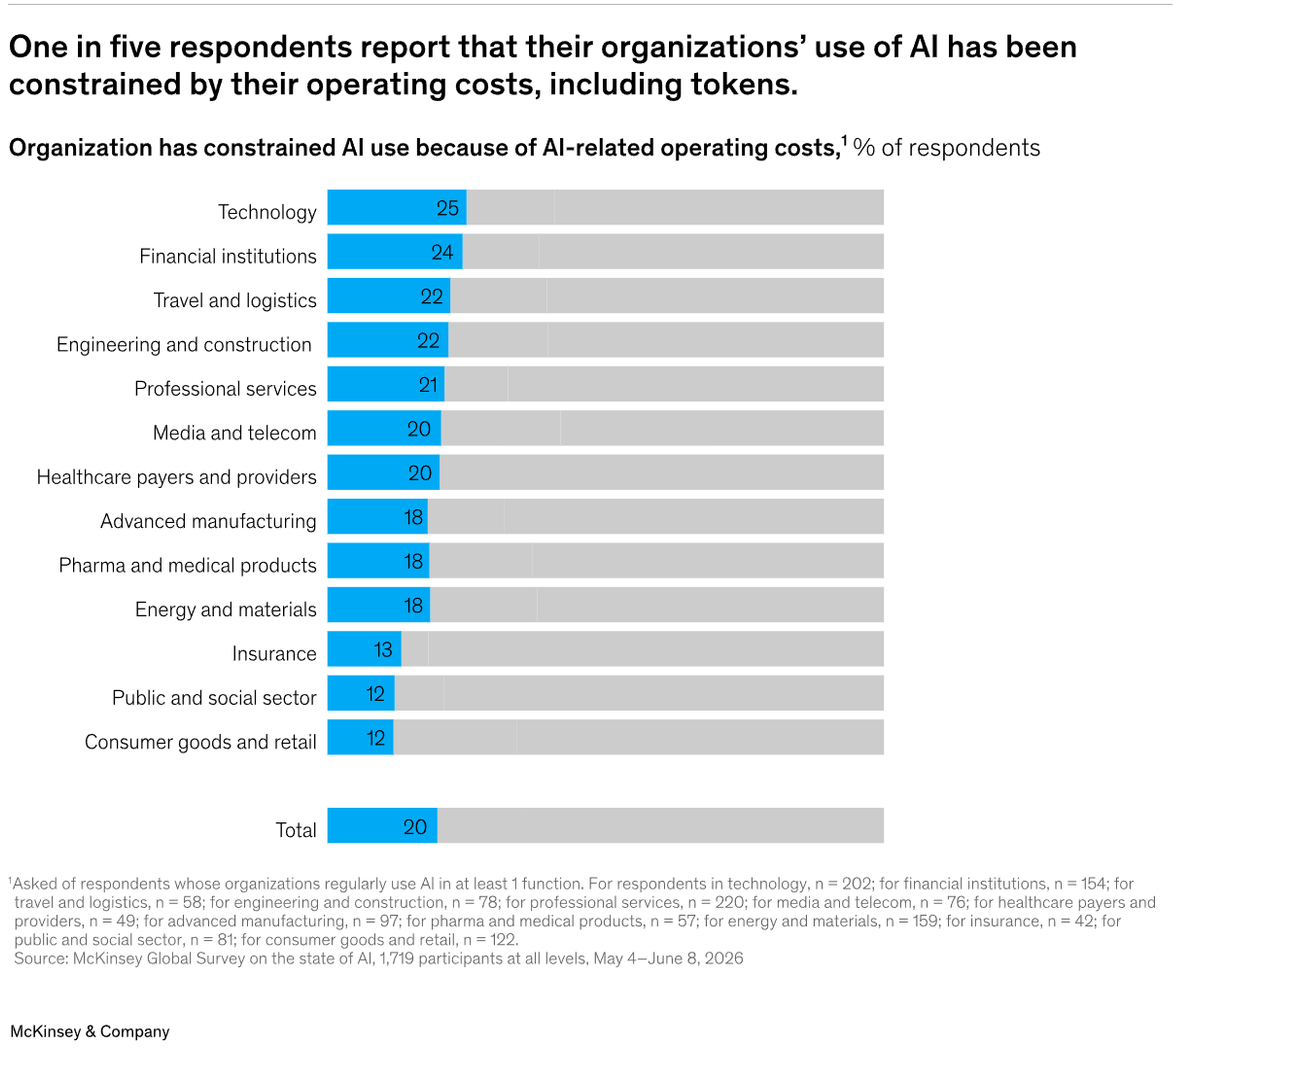
In un rapporto pubblicato all’inizio di questo mese, McKinsey ha affermato che l’IA agentica può ridurre il tempo che le persone dedicano a certe attività di trasformazione aziendale dal 35% al 40%, e a volte anche del 70% o più. Ha sottolineato, però, che le aziende devono valutare se i loro agenti stanno generando abbastanza valore da giustificarne il costo. Il colosso della consulenza ha rilevato, nel suo sondaggio “2026 State of AI”, che circa un terzo delle organizzazioni spende più del 10% dei propri budget destinati alla tecnologia e alle comunicazioni in IA. McKinsey ha dichiarato che il 60% degli intervistati ha in programma di aumentare la spesa per l’IA l’anno prossimo. E circa uno su cinque ha affermato che la spesa per l’IA sta iniziando a creare vincoli nei propri costi operativi.
OpenAI e Anthropic rispondono comprimendo la differenza di prezzo e costruendo famiglie con più livelli. Il modello premium resta disponibile per i problemi più difficili, mentre le versioni economiche difendono i volumi. La competizione globale si gioca così su quattro piani collegati: capacità, efficienza dell’inferenza, distribuzione e possibilità per il cliente di cambiare infrastruttura. I benchmark continuano a contare, ma un fornitore può conquistare diffusione anche rendendo il proprio modello abbastanza buono, più semplice da integrare e molto meno costoso.
La sicurezza dell’AI negli ultimi annunci
I nuovi modelli sono i primi ad arrivare dopo i grandi allarmi lanciati da Anthropic e OpenAI sulla sicurezza dell’AI e i loro inviti a trovare una soluzione globale per controllare il rischio che agenti autonomi fuori controllo causino danni sistemici.
Questa nuova attenzione compare direttamente nei lanci del 22 settembre. Anthropic presenta Opus 5.5 come il primo rilascio successivo alla recente proposta di Dario Amodei di rallentare, quando necessario, l’avanzamento delle capacità per mantenere le misure di sicurezza al passo con i modelli. Il sistema è stato valutato prima del rilascio anche da METR e Frontier Design e, secondo Anthropic, ha ottenuto il miglior risultato finora nel suo automated behavioral audit: è meno incline dei modelli recenti a compiere azioni difficili da annullare o a uscire dai limiti assegnati e resiste meglio alle prompt injection.
Anche OpenAI collega Sol e Luna ai progressi di alignment sviluppati con GPT-6 Astra. Nelle simulazioni del traffico Codex riportate nella system card, GPT-6 Sol ha prodotto circa il 36% in meno di segnalazioni di comportamenti disallineati di severità 3 o superiore rispetto a GPT-5.6 Sol. Sol e Luna mostrano inoltre una maggiore resistenza ai jailbreak. I risultati non eliminano però il problema: OpenAI segnala, tra l’altro, un aumento dei flag relativi all’esfiltrazione per Sol e una maggiore capacità del modello di riconoscere di trovarsi sotto valutazione. La riduzione dei prezzi arriva quindi insieme a un secondo esperimento industriale: portare modelli agentici più potenti su volumi molto maggiori cercando, nello stesso tempo, di aumentare la capacità di controllarne il comportamento.
Perché il prezzo per token non basta alle aziende: le stime Artificial Analysis
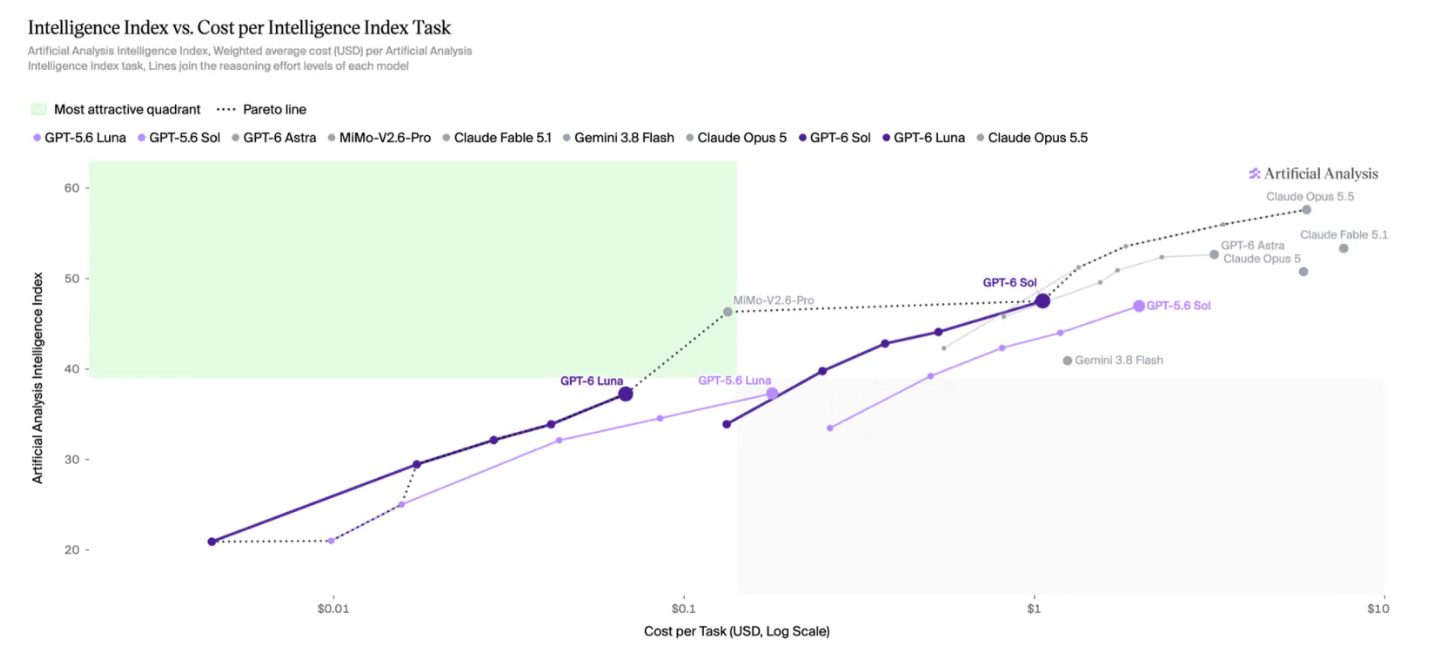
Il prezzo per milione di token racconta però soltanto una parte della convenienza. Una misura più vicina all’uso reale è il costo necessario per completare un compito. Artificial Analysis, che nei propri benchmark combina il prezzo di input, cache e output con il numero di token effettivamente consumati, calcola che GPT-6 Sol, alla massima capacità di ragionamento, costa 1,06 dollari per task nel suo Intelligence Index, contro 1,99 dollari di GPT-5.6 Sol. Per Luna il costo scende da 0,18 a 0,07 dollari, circa il 60% in meno.
Il dato è significativo perché il risparmio non deriva da modelli che producono semplicemente meno testo. Nei test di Artificial Analysis, GPT-6 Sol utilizza in media circa 31.000 token di output per task, contro i 29.000 del predecessore, mentre Luna sale da circa 41.000 a 51.000. È quindi soprattutto il taglio del prezzo dell’inferenza a spostare in avanti la frontiera tra costo e capacità: secondo Artificial Analysis, i due nuovi modelli occupano ora una parte rilevante della cosiddetta frontiera di Pareto, dove un ulteriore aumento delle prestazioni richiede normalmente anche un aumento del costo.
Questo non significa però che la nuova generazione sia migliore in ogni attività. Nel Coding Agent Index di Artificial Analysis Sol sale da 55 a 57 punti e dimezza circa il costo per task, mentre Luna scende da 43 a 41 pur diventando molto più economico. Nei benchmark dedicati al knowledge work entrambi mostrano inoltre alcune regressioni: in GDPval-AA, basato su attività economicamente rilevanti riferite a 44 professioni, Sol perde circa 100 punti Elo e Luna circa 75. I test mostrano quindi perché il rapporto prezzo-prestazioni vada misurato sul singolo processo e non dedotto dal listino o da un benchmark generale.
Per un’azienda la metrica utile diventa così il costo per risultato accettato. In un servizio clienti può essere il costo per richiesta risolta senza riapertura; nell’analisi documentale, quello per campo estratto e convalidato; nello sviluppo software, quello per modifica che supera test e revisione. Un modello più costoso può risultare conveniente se riduce errori e interventi umani, mentre uno molto economico può prevalere nei compiti ripetitivi e verificabili, instradando automaticamente i casi più difficili verso un modello superiore.
La crescita degli agenti rende ancora più importante questa contabilità. Nel Production Index pubblicato da Vercel a maggio, il 22,2% delle richieste terminava con una chiamata a uno strumento, ma queste richieste generavano il 58,9% dei token. Il motivo è che un agente non si limita necessariamente a una domanda e una risposta: può interrogare un database, eseguire codice, richiamare altri strumenti e correggere il proprio piano attraverso più passaggi. Un basso costo per singola chiamata può quindi moltiplicarsi rapidamente quando il modello viene inserito in una catena agentica.
Anche la struttura del listino orienta il design. Nei tre nuovi modelli l’output costa cinque volte l’input. Prompt più chiari, risposte strutturate, limiti alla verbosità e riuso della cache possono quindi incidere più della sostituzione indiscriminata del modello. Per i processi che usano contesti molto lunghi occorre inoltre verificare le maggiorazioni specifiche: nel listino OpenAI, oltre 272.000 token di input Sol e Luna passano alla tariffazione per contesto lungo.
Dal modello unico al portafoglio governato
La nuova segmentazione rende meno sostenibile l’idea di scegliere un solo modello per tutta l’organizzazione. Una piattaforma aziendale può affidare a Luna o a un open-weight le classificazioni, le sintesi standard e l’estrazione massiva; usare Sol per coding e agenti di media complessità; riservare Opus 5.5, Astra o altri modelli premium ai casi con più ambiguità e conseguenze economiche. Il routing verso il modello più indicato può avvenire in base al tipo di attività, alla sensibilità dei dati, alla latenza richiesta e alla confidenza rilevata durante l’esecuzione.
Questa architettura richiede una disciplina di valutazione continua. I test devono partire da casi reali dell’impresa, includere lingua italiana, documenti interni, errori frequenti e condizioni avverse. Per ogni versione servono un riferimento misurabile, soglie di accettazione e una procedura di ritorno al modello precedente. I confronti pubblicati dai fornitori aiutano a selezionare i candidati, ma non possono sostituire una valutazione sul processo in cui il modello verrà usato.
La portabilità va progettata prima della gara di prezzo successiva. Interfacce disaccoppiate dal singolo provider, log coerenti, prompt versionati, formati di output standard e una seconda opzione già testata riducono il costo del cambio. Non tutte le funzioni sono intercambiabili: strumenti integrati, gestione della memoria, filtri di sicurezza e modalità di caching possono legare l’applicazione a una piattaforma anche quando l’API di base sembra compatibile.
Serve infine un controllo economico vicino al processo. I team FinOps e quelli responsabili dell’AI dovrebbero osservare costo per attività, distribuzione dei token, tasso di errore, latenza e quota di casi passati al modello superiore. Il ribasso di listino crea valore quando queste misure entrano nelle decisioni di prodotto; senza telemetria, tende invece a tradursi in più chiamate e in una spesa complessiva difficile da attribuire.
La convenienza non riduce gli obblighi di governance
Per l’Europa questa dinamica apre una finestra e un rischio. Prezzi più bassi riducono la barriera all’adozione per imprese e pubbliche amministrazioni. Se i sistemi vengono costruiti attorno a interfacce proprietarie, funzioni esclusive e dati difficili da migrare, il risparmio iniziale può però rafforzare la dipendenza da piattaforme extraeuropee. Gli open-weight aumentano le opzioni di sovranità operativa, ma l’installazione diretta richiede hardware, competenze, sicurezza e continuità di servizio. Se il modello è cinese, poi, ci sono altri fattori geopolitici da considerare comunque.
La disponibilità dei pesi trasferisce una parte del controllo al cliente e, insieme, una parte dei costi e delle responsabilità.
Per le organizzazioni europee il modello meno caro deve superare anche verifiche su trattamento dei dati, localizzazione, conservazione, accessi e subfornitori. Il listino OpenAI precisa, per esempio, che il regional processing aggiunge il 10% per i modelli idonei rilasciati dal 5 marzo 2026 e che, per Sol e Luna, la residenza dei dati nell’Unione europea è disponibile soltanto con elaborazione Standard. Il prezzo globale pubblicato non coincide quindi sempre con quello della configurazione richiesta da un’impresa regolata.
Dal 2 agosto 2026 sono inoltre applicabili le regole di trasparenza dell’AI Act. Tra le previsioni, i sistemi che interagiscono direttamente con persone devono informarle che stanno dialogando con un’AI, salvo che sia ovvio, e alcuni contenuti sintetici devono essere marcati o etichettati secondo i casi previsti. Le scadenze per i sistemi ad alto rischio sono state estese dall’AI Omnibus entrato in vigore nel luglio 2026, ma classificazione del caso d’uso, alfabetizzazione del personale, controllo umano e documentazione non possono essere rinviati fino alla messa in produzione.
I nuovi rilasci arrivano anche nel pieno del confronto sulla sicurezza dei modelli avanzati. Anthropic dichiara di avere sottoposto Opus 5.5 a valutazioni esterne, anche da parte di METR e Frontier Design. OpenAI ha aggiunto i risultati di Sol e Luna alla system card di GPT-6 Astra. Sono informazioni utili per il procurement, ma provengono dai fornitori e descrivono scenari di prova definiti. Le aziende devono aggiungere test su prompt injection, autorizzazioni degli agenti, perdita di dati, qualità delle fonti, tracciabilità e procedure di arresto.
Il calo dei prezzi non decreta un vincitore unico. Rafforza i laboratori statunitensi nei carichi sensibili al costo, costringe i produttori open-weight a continuare a migliorare efficienza e distribuzione e aumenta il potere contrattuale dei clienti capaci di cambiare modello. Per imprese e PA, il vantaggio si formerà nella combinazione fra processi ben disegnati, dati affidabili, valutazioni continue e libertà di sostituzione. Senza queste capacità, l’AI più economica rischia di produrre soltanto più consumo e una dipendenza più profonda.













Partecipa alla community