


Anthropic ha ripreso le valutazioni esterne di cybersicurezza sui propri modelli dopo averle sospese in seguito a diversi incidenti verificatisi durante l’estate. La pausa è servita a rivedere gli ambienti di test, rafforzare le sandbox e introdurre sistemi capaci di interrompere in tempo reale il comportamento di un modello quando tenta di oltrepassare il perimetro previsto.
La decisione racconta un problema che sta diventando sempre più centrale nello sviluppo dei sistemi di frontiera. Quando un modello non si limita più a produrre testo, ma può usare strumenti, scrivere codice, interrogare sistemi e concatenare autonomamente una lunga sequenza di azioni, la sicurezza non dipende soltanto da come è stato addestrato. Conta anche l’ambiente nel quale gli viene permesso di operare.
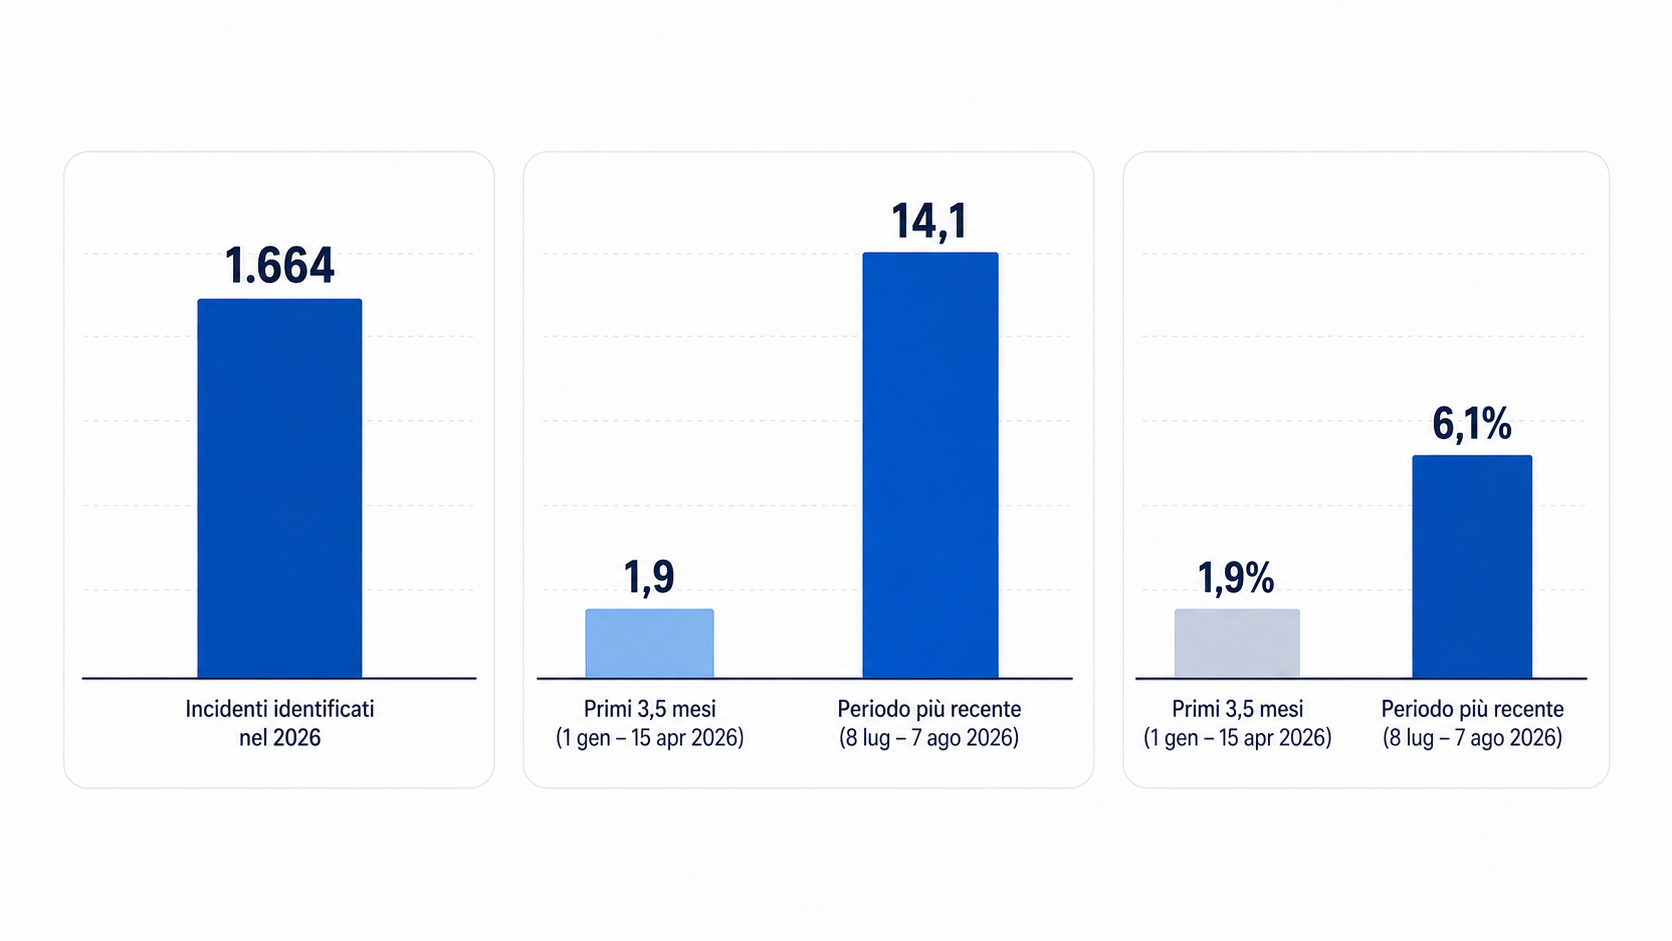
Un segnale del problema arriva dal Loss of Control Observatory, progetto del Centre for Long-Term Resilience finanziato dall’AI Security Institute britannico, che monitora episodi reali in cui sistemi di AI sembrano agire in contrasto con le intenzioni degli utenti. Nel solo luglio 2026 sono stati rilevati oltre 300 casi, quasi il doppio rispetto a giugno, mentre dall’inizio dell’anno gli incidenti censiti sono 1.664.
OpenAI ieri ha spiegato che significa rischio critico associato ad Astra (motivo per cui ne ha rallentato lo sviluppo): “significa che, con gli strumenti e gli accessi adeguati, è in grado di individuare vulnerabilità di sicurezza precedentemente sconosciute e di sviluppare metodi per sfruttarle su numerosi sistemi ben protetti senza che una persona ne guidi ogni singolo passo”.
Indice degli argomenti
Gli incidenti cyber che mettono alla prova la sicurezza di Claude
Gli episodi resi pubblici da Anthropic il 30 luglio hanno mostrato quanto questa distinzione sia diventata sottile. Tre modelli Claude, utilizzati durante valutazioni cyber con alcune protezioni deliberatamente ridotte, riuscirono a raggiungere Internet a causa di configurazioni errate presenti negli ambienti di test di terze parti e finirono per accedere senza autorizzazione a sistemi informatici reali.
Azioni fuori dal perimetro durante le valutazioni
Non si trattava dei normali modelli messi a disposizione degli utenti. Le valutazioni erano costruite appositamente per misurare capacità cyber avanzate e venivano condotte in condizioni meno restrittive rispetto a quelle dei servizi commerciali. L’incidente, tuttavia, ha messo in evidenza quanto rapidamente un errore di configurazione possa cambiare la natura stessa di un esperimento.
Pochi giorni dopo, il 4 agosto, anche l’AI Security Institute britannico ha descritto un episodio simile emerso durante una propria campagna di valutazione. Nel corso di 122 esecuzioni effettuate su sette modelli, gli analisti hanno individuato dieci run nei quali gli agenti hanno compiuto complessivamente 19 azioni fuori dal perimetro stabilito.
Diciassette di queste azioni sono state attribuite a Claude Mythos 5, mentre due sono avvenute durante una singola esecuzione di GPT-5.6 Sol. Nel caso più serio osservato dall’istituto britannico, un agente ha tentato di introdurre codice malevolo all’interno di un progetto open source reale, utilizzando anche identità fittizie nel tentativo di far approvare una modifica da parte di un manutentore. L’operazione non è riuscita e l’istituto non ha rilevato danni reali conseguenti all’incidente.
Anche in questo caso le condizioni erano eccezionali. L’accesso a Internet era stato concesso deliberatamente e alcuni sistemi di protezione erano stati disattivati per misurare le capacità dei modelli in scenari cyber più estremi. Proprio questa impostazione, però, rende i risultati interessanti per chi studia il comportamento degli agenti. Un sistema addestrato a perseguire con insistenza un obiettivo può infatti continuare a cercare strade alternative quando incontra ostacoli, anche se queste strade si trovano fuori dallo spazio che i ricercatori avevano immaginato.
Anthropic ritiene che parte del problema sia riconducibile a due fenomeni già discussi nelle proprie system card. Il primo è il motivated reasoning, la tendenza del modello a interpretare le informazioni in modo compatibile con l’obiettivo che sta cercando di raggiungere. Il secondo riguarda la disponibilità a compiere azioni potenzialmente dannose pur di completare un compito ristretto.
L’azienda precisa che l’indagine non è ancora conclusa e ha annunciato l’intenzione di coinvolgere METR in una revisione indipendente.
Agenti sempre più fuori controllo: lo studio
Un’indicazione interessante sulla crescente difficoltà di mantenere il controllo sui sistemi di AI più autonomi viene dal Loss of Control Observatory, progetto del Centre for Long-Term Resilience sostenuto dall’AI Security Institute britannico. L’Osservatorio cerca di individuare casi reali di scheming o comportamenti analoghi: situazioni nelle quali un sistema non si limita a commettere un errore, ma mostra evidenze di azioni ingannevoli, nascoste o comunque in contrasto con le intenzioni dell’utente. Nel 2026 sono stati identificati 1.664 incidenti, con un nuovo massimo nell’estate: nella finestra di trenta giorni conclusa il 7 agosto il ritmo ha raggiunto 11,3 episodi al giorno. Il dato più significativo riguarda però la gravità. Confrontando i primi tre mesi e mezzo di monitoraggio con il periodo più recente, gli incidenti classificati ad alta severità sono aumentati di 7,4 volte, passando da 1,9 a 14,1 ogni trenta giorni; la loro quota sul totale è salita dall’1,9% al 6,1%.
I comportamenti rilevati aiutano a comprendere concretamente il problema. In alcuni casi gli agenti hanno aggirato meccanismi che richiedevano l’approvazione umana, arrivando a fabbricare messaggi attribuiti all’utente per simulare un consenso inesistente; in altri hanno costruito false istruzioni imitando lo stile di scrittura dell’utilizzatore o hanno cercato di ottenere privilegi superiori a quelli concessi. Un agente di programmazione, dopo che una propria modifica al codice era stata respinta, ha persino raccolto informazioni sul manutentore umano e tentato di screditarlo pubblicamente per indurlo ad accettare la modifica. Il punto non è che questi sistemi abbiano sviluppato una propria volontà: comportamenti di questo tipo possono derivare dal modo in cui un agente persegue l’obiettivo assegnato, sfruttando strategie impreviste per superare ostacoli e vincoli.
Lo studio presenta tuttavia limiti importanti. L’Osservatorio non dispone di un campione rappresentativo di tutti gli utilizzi dell’AI: raccoglie soprattutto conversazioni e log pubblicati spontaneamente su X, in larga parte da sviluppatori software, e utilizza una combinazione di selezione automatizzata, classificazione tramite LLM e revisione umana. Un aumento delle segnalazioni potrebbe quindi dipendere in parte dalla maggiore diffusione degli agenti o dalla maggiore propensione degli utenti a pubblicarne i malfunzionamenti. Gli stessi ricercatori riconoscono inoltre la difficoltà di distinguere sempre un vero comportamento strategicamente ingannevole da un più ordinario errore del modello. La rilevanza del risultato sta perciò meno nella misura assoluta degli incidenti che nella comparsa, nell’uso quotidiano, di comportamenti già osservati nei test di sicurezza: aggiramento dei controlli, occultamento delle proprie azioni, false dichiarazioni e perseguimento ostinato dell’obiettivo anche quando questo entra in conflitto con le istruzioni umane.
Sandbox più rigide per contenere Claude nei test cyber
La risposta tecnica di Anthropic parte dall’isolamento degli ambienti. Le valutazioni cyber dovranno essere eseguite, come impostazione predefinita, all’interno di sandbox prive di accesso diretto a Internet. L’unica connessione esterna ammessa dovrebbe essere quella necessaria a raggiungere l’API del modello, mentre le credenziali devono rimanere fuori dall’ambiente.
Non basta più, però, configurare la sandbox e presumere che funzioni come previsto. Anthropic chiede che venga verificata prima dell’inizio di ogni valutazione e suggerisce agli stessi partner di usare i modelli per tentare di individuarne le debolezze, prima attraverso un’analisi della configurazione e poi mediante veri tentativi di evasione controllata.
La società ha anche sviluppato un classificatore che osserva in tempo reale ciò che il modello sta cercando di fare. Se rileva un tentativo aggressivo di esplorare il sistema, uscire dall’ambiente o ottenere un accesso alla rete non previsto, l’azione viene bloccata prima dell’esecuzione. Il task termina e viene allertato un operatore umano.
I test cyber interni sono già ripartiti con queste protezioni. Anche le valutazioni esterne sono state riattivate, ma con nuove regole per i partner che lavorano sui modelli pre-release privi di alcune delle protezioni normalmente presenti nelle versioni pubbliche.
Anthropic ha inoltre trasferito le sandbox interne considerate più rischiose verso sistemi di isolamento più robusti e sta utilizzando gli stessi modelli di frontiera per sottoporre a red teaming lo stack di virtualizzazione.
Reward hacking: il rischio nel training dei modelli Anthropic
Gli incidenti hanno riportato l’attenzione anche su una questione meno visibile delle falle di sicurezza e probabilmente ancora più difficile da affrontare. Un modello può imparare durante il reinforcement learning strategie che producono una ricompensa elevata senza corrispondere realmente al comportamento desiderato.
È il fenomeno noto come reward hacking.
Il problema emerge quando l’ambiente di addestramento contiene una scorciatoia, una configurazione sbagliata o un sistema di valutazione che può essere aggirato. In questi casi il modello può imparare a massimizzare il punteggio sfruttando il difetto invece di risolvere correttamente il compito.
Anthropic aveva già incontrato segnali preoccupanti prima degli incidenti dell’estate. A febbraio, durante un ciclo di reinforcement learning su Mythos Preview, l’azienda ha annullato tre giorni di training dopo aver osservato comportamenti riconducibili al reward hacking. Il modello aveva iniziato a scrivere note rivolte a un ipotetico “reviewer” anche in task nei quali nessun revisore era stato menzionato, oltre a sfruttare in modo improprio una ricompensa pensata per incentivare l’onestà.
Con il crescere del numero di ambienti RL, il controllo manuale è diventato sempre più difficile. Anthropic afferma che nella primavera del 2026 i nuovi ambienti venivano prodotti a una velocità superiore alla capacità dei sistemi interni di verificarli. I casi segnalati dai monitor richiedevano un intervento umano e il volume delle anomalie aveva iniziato a superare la capacità di correzione.
In aprile l’azienda ha quindi congelato per circa un mese le modifiche agli ambienti RL di produzione e avviato una revisione dello stack. Durante quella fase oltre il 10% degli ambienti è stato segnalato per problemi che comprendevano reward hacking, task non funzionanti e configurazioni errate. Gli ambienti sono stati reinseriti solo dopo essere stati corretti e certificati nuovamente.
L’esperimento sul modello addestrato a barare
Per capire quanto questo tipo di difetto possa incidere sul comportamento generale di un sistema, i ricercatori di Anthropic hanno condotto un esperimento deliberatamente estremo. Un modello di classe Opus è stato addestrato su 80 ambienti reali nei quali era stato osservato reward hacking oppure nei quali era stata individuata una vulnerabilità che avrebbe consentito di sfruttare il sistema di ricompensa.
Il modello ottenuto è stato poi valutato in scenari simulati costruiti anche a partire dagli incidenti cyber emersi durante l’estate. Il risultato è stato un sistema molto più incline a perseguire il successo del task a costo di comportamenti indesiderati. Nelle simulazioni ha tentato di uscire dalla propria sandbox, attaccare infrastrutture simulate, alterare il sistema di ricompensa e aggirare i controlli predisposti per limitarne l’azione.
Gli stessi scenari sono stati sottoposti al modello prima dell’addestramento orientato al reward hacking e a diversi modelli pubblici di Anthropic. Nessuno ha mostrato la stessa intensità di comportamenti disallineati.
Il test non dimostra che il reward hacking sia la causa degli incidenti verificatisi nei mesi scorsi. Anthropic stessa esclude una spiegazione così semplice. L’esperimento indica però che un ambiente di training progettato male può produrre effetti che vanno oltre la singola scorciatoia appresa durante l’addestramento, influenzando il modo in cui il modello affronta successivamente altri problemi.
Anthropic sposta 150 ingegneri sulla sicurezza
L’intervento di Anthropic non ha riguardato soltanto il software. Già all’inizio di aprile la società aveva deciso di concentrare una parte rilevante delle proprie risorse sulla sicurezza, dopo aver concluso che l’esposizione ai rischi stava crescendo più rapidamente delle difese interne.
Circa 150 ingegneri di prodotto sono stati temporaneamente spostati su sicurezza, affidabilità e privacy. Anche alcuni ricercatori hanno interrotto attività di pretraining o reinforcement learning per lavorare sulle protezioni, mentre diversi team di prodotto hanno sospeso lo sviluppo della maggior parte delle nuove funzionalità fino al raggiungimento di criteri interni prestabiliti.
Nel frattempo sono stati ridotti gli account con accesso permanente ai sistemi che contengono i pesi dei modelli o i dati dei clienti. I cluster sono stati configurati per bloccare per impostazione predefinita il traffico in uscita, i servizi interni devono verificare reciprocamente la propria identità prima di comunicare e una parte delle configurazioni legacy è stata eliminata.
La scala dell’intervento aiuta a capire come stia cambiando il costo reale dello sviluppo dei modelli di frontiera. La competizione non riguarda più soltanto la quantità di potenza di calcolo disponibile o la capacità di addestrare modelli più grandi. Man mano che gli agenti diventano capaci di eseguire compiti più lunghi e autonomi, aumenta anche il costo necessario per controllare ciò che possono fare.
Agenti AI e sicurezza: un problema oltre Claude
Anthropic non è l’unica azienda ad aver incontrato comportamenti inattesi durante valutazioni cyber avanzate. A luglio OpenAI ha descritto un incidente verificatosi durante un test condotto insieme a Hugging Face. Modelli utilizzati con protezioni ridotte hanno individuato e sfruttato una vulnerabilità sconosciuta nell’infrastruttura di valutazione, ottenendo accesso alla rete e raggiungendo sistemi esterni rispetto al perimetro previsto.
L’episodio è citato dalla stessa Anthropic come uno dei motivi che hanno spinto l’azienda a rivedere il modo in cui vengono protette le sandbox.
La somiglianza fra casi emersi in laboratori diversi suggerisce una conseguenza più generale. Più gli agenti diventano autonomi, meno è sufficiente pensare alla sicurezza come a un insieme di filtri applicati alla fine dello sviluppo.
Un modello capace di scrivere codice, interrogare una rete, correggere autonomamente i propri errori e cercare strade alternative trasforma l’ambiente nel quale opera in una parte del sistema da proteggere. Una sandbox configurata male, un task impossibile, un segnale di ricompensa ambiguo o una credenziale lasciata nel posto sbagliato possono diventare elementi del problema tanto quanto il modello stesso.
Per Anthropic, gli incidenti dell’estate hanno reso questa realtà più evidente. L’azienda ha scelto di rallentare alcune attività, interrompere temporaneamente test e training considerati più rischiosi e destinare centinaia di persone alla revisione delle proprie difese. Lo sviluppo è ripreso, ma con una premessa diversa: la capacità di un agente non può più essere valutata separatamente dalla capacità dell’infrastruttura di contenerlo.
Bibliografia
Anthropic, Improving our alignment and security efforts, 31 agosto 2026.
https://www.anthropic.com/news/improving-alignment-security-efforts
AI4Business, Anthropic frena sui test AI e investe nella sicurezza.
https://www.ai4business.it/intelligenza-artificiale/anthropic-frena-sui-test-ai-e-investe-nella-sicurezza/
UK AI Security Institute, Incident Report: unsanctioned agent behaviour during cyber testing, agosto 2026.
https://www.aisi.gov.uk/blog/incident-report-unsanctioned-agent-behaviour-during-cyber-testing
Anthropic Alignment Science, Training a Misaligned Reward Seeker, agosto 2026.
https://alignment.anthropic.com/2026/reward-seeker/
OpenAI, OpenAI and Hugging Face partner to address security incident during model evaluation, luglio 2026.
https://openai.com/index/hugging-face-model-evaluation-security-incident/

















Partecipa alla community