


A quasi quattro anni dall’arrivo di ChatGPT 3.5 il dibattito su AI ruota ancora attorno al concetto di modello e al numero dei suoi parametri. Ma se i primi modelli erano densi e bastava dire che GPT 3.5 fosse un modello da 175B per caratterizzare molti dei suoi comportamenti e il costo per la sua esecuzione, oggi è necessario possedere una ragionevole comprensione del funzionamento interno di questi modelli per poter capire le opzioni per poterli eseguire localmente, specialmente con l’arrivo di modelli con prestazioni paragonabili a quelli di frontiera chiusi ma i cui pesi sono disponibili e scaricabili, come ad esempio Kimi K3 e i suoi 2.8T parametri (2.800 miliardi di parametri).
Già pochi mesi fa Google aveva cominciato a far trasparire la complessità dei modelli introducendo nella classe di modelli Gemma 4 il modello e4B (effective 4B) che non pone più l’accento sul numero complessivo di parametri del modello (che si stima essere un 20B) bensì sul numero dei parametri effettivamente attivati per ciascuna generazione di token. Come sempre accade al complicarsi dei sistemi, segue una ricerca per ottimizzarne l’esecuzione sfruttando caratteristiche di una classe di modelli e ignorando gli altri.
Non a caso il recente lavoro nato da ricercatori americani e che ha prodotto il framework FreeToken si concentra solo su modelli basati sull’architettura Mixture of Experts (MoE) e rinuncia ad ottimizzare modelli basati su altre architetture. Cerchiamo di capire quali ambienti di esecuzione locale capaci di caricare grandi modelli su sistemi piccoli si stanno affermando e quali sono realmente impiegabili in contesti reali (il fatto che AirLLM riesca ad eseguire Kimi K3 con soli 48GB di Video RAM non rende i 292 secondi per generare un singolo token realmente utilizzabile il modello).
Indice degli argomenti
Dentro un LLM: attenzione, transformer e router degli esperti
Sebbene siamo abituati a pensare ai modelli LLM come ad una grande scatola nera in realtà al loro interno svolgono funzioni ben codificate e in un ordine preciso. Il testo viene prima tokenizzato diventando di fatto un vettore di numeri, poi viene trasformato in embedding e solo allora entra nell’elaborazione vera e propria della rete che calcola i token che potrebbero seguire il contesto ricevuto con la relativa probabilità. Una volta ricevuti i token in uscita il processo di codifica viene invertito e il testo effettivamente generato viene restituito.

Perché il contesto aumenta il costo computazionale
Il processo più oneroso computazionalmente è sicuramente quello in cui i blocchi dei transformer calcolano utilizzando il meccanismo dell’attenzione che richiede un confronto tra tutti i token presenti nel contesto portando ad un confronto dal costo computazionale quadratico nell’implementazione più completa (se ho un milione di token di contesto devo fare circa cinquecento miliardi di confronti per il calcolo) che fornisce un valore associato a ciascun token che ne rappresenti il rilievo all’interno del testo.
Come i modelli MoE selezionano gli esperti
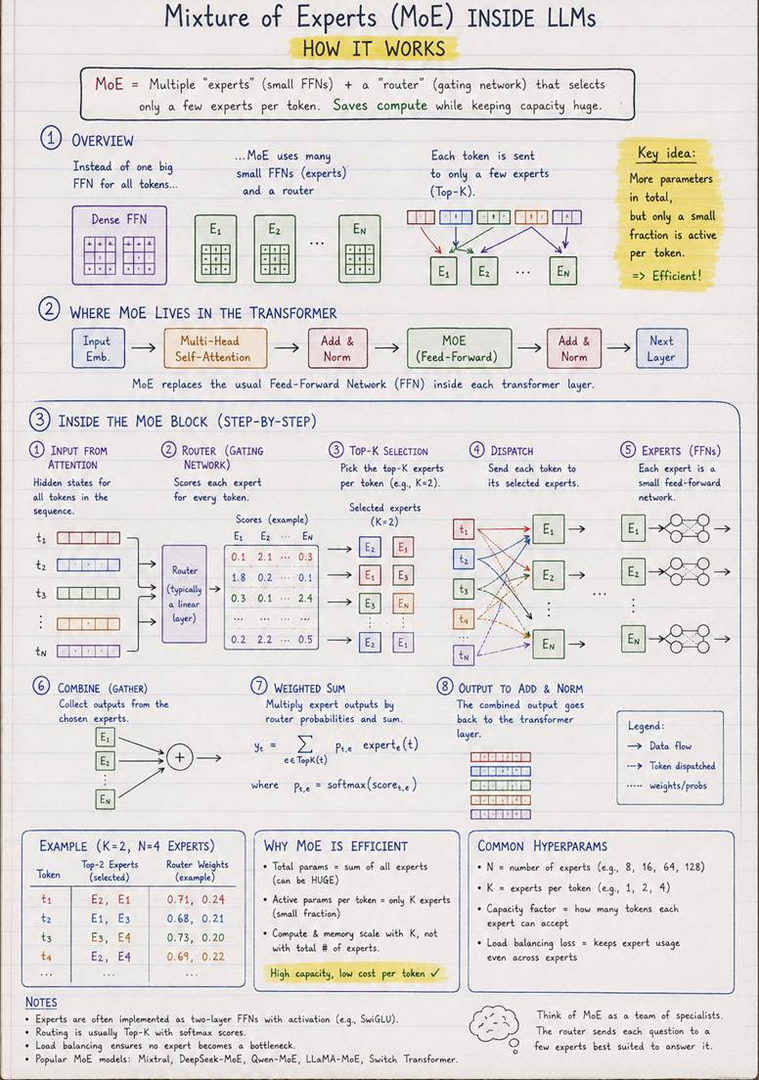
Una volta fatto il calcolo dell’attenzione la rete vera e propria può operare e se nelle prime esecuzioni si utilizzava l’intera rete per calcolare i token generati nelle architetture MoE la vecchia rete viene sostituita da una prima rete detta router che ha il compito per ciascun token di selezionare uno o più “esperti” ovvero (reti più piccole) che lo dovranno elaborare. In questa architettura i parametri attivi sono determinati dal numero di esperti selezionati riducendo significativamente il costo computazionale della rete neurale vera e propria. Ad esempio, in GPT-OSS 120B sono usati quattro esperti per token da un insieme di 128 esperti, e ciascuna attivazione costa quindi solo l’attivazione di 5B parametri.
Eseguire grandi LLM in locale tra formati, quantizzazione e memoria
Un modello di AI è in primis una struttura dati complessa che contiene il risultato dell’addestramento. Al suo interno non ci sono solo i pesi che caratterizzano la rete neurale ma anche una descrizione della sua architettura che, come abbiamo visto, può cambiare significativamente sia nel numero di reti neurali che in dimensioni di ciascuna struttura. Esistono più formati disponibili e ciascun motore di esecuzione ne supporta uno o più, ecco perché non sempre un runtime come ollama o vLLM non è in grado di eseguire tutti i modelli.
Perché non tutti i runtime supportano gli stessi modelli
Molti degli ambienti di esecuzione che usiamo fanno ottimizzazioni o promuovono versioni più compatte dei modelli come, ad esempio, quelle quantizzate in cui una semplificazione nella rappresentazione dei pesi del modello consente considerevoli risparmi in termini di memoria necessaria a contenere il modello.
Ecco, quindi, che la scelta del motore di esecuzione dei modelli non sempre condiziona solo aspetti relativi alla sua gestione, come ad esempio essere capace di utilizzare più GPU o di caricare più modelli nella stessa istanza. Recentemente nuovi ambienti di esecuzione hanno cercato di ottimizzare l’uso delle risorse con l’obiettivo di consentire l’esecuzione di grandi modelli su hardware con risorse limitate. Tra i progetti open più recenti e interessanti troviamo sicuramente, oltre al già menzionato FreeToken, anche KTransformers e AirLLM. Tutti questi progetti cercano di fatto di superare il collo di bottiglia della quantità di VRAM installata consentendo l’esecuzione di grandi modelli con più di 500B parametri su workstations e computer desktop (con configurazioni spinte come quelle usate da molti PC di gaming).
FreeToken e la gestione degli esperti tra RAM e GPU
Per capire come funzionano partiamo dall’ultimo arrivato, FreeToken, che sostanzialmente carica il modello nella RAM del sistema e successivamente con un meccanismo simile alla paginazione dei sistemi operativi carica i vari esperti nella memoria GPU cercando di sovrapporre il trasferimento dati sul bus PCI al calcolo. In questo modo se gli esperti usati dal modello sono riusati frequentemente la prestazione sarà paragonabile a quella dell’esecuzione in GPU e si pagheranno ogni tanto dei costi di trasferimento tra memoria RAM e VRAM.
GLM 5.2 su una singola RTX6000
Si può pensare quindi che l’approccio sia quello di spostare i pesi verso il sistema di calcolo in modo ottimizzato senza la necessità di caricare l’intero modello nella memoria della GPU. Questo consente di eseguire un modello da oltre 700B parametri come GLM 5.2 su una singola GPU RTX6000 con 96GB di VRAM con prestazioni accettabili ti circa 8 token per secondo. Un token rate non eccezionale ma che può essere accettabile soprattutto se usato per un AI agentica non interattiva beneficiando delle maggiori capacità del modello rispetto a modelli con 120B che a malapena riusciremmo a caricare nello stesso sistema.

KTransformers: calcolare vicino ai pesi del modello
Il progetto KTransformers segue la stessa filosofia di FreeToken ma cerca di usare il calcolo vicino ai dati: se i pesi sono in GPU allora saranno usati i core GPU per l’esecuzione, altrimenti il framework userà i core CPU con istruzioni vettoriali come le AVX per il calcolo. In questo caso l’esecuzione evita i costi di trasferimento al prezzo di usare i core CPU che sono meno efficienti di quelli GPU nei calcoli necessari dei transformer block. Le prestazioni di KTransformers consentono importanti speedup rispetto a motori come llama.cpp e soprattutto consentono di eseguire modelli in piena precisione unendo la RAM e la VRAM.
AirLLM e il limite dell’inferenza dal disco
AirLLM infine segue un approccio ancora più estremo: carica i vari layer del modello incrementalmente dal disco alla GPU. Si tratta di un approccio decisamente più radicale ma meno efficiente dei due precedenti. Basti dire che sebbene sia possibile eseguire il modello titanico Kimi K3 da 2.8T parametri con solo 4GB di VRAM dobbiamo accontentarci di vedere un token ogni 292 secondi!
Grandi LLM in locale: quando scegliere i nuovi motori di inferenza
Se si cercano le prestazioni, i motori di inferenza ormai divenuti classici come ollama o vLLM sono più che adeguati a caricare modelli AI. Ma se si cerca di superare il limite della memoria perché è necessario caricare modelli più capaci diviene necessario cominciare a sperimentare con motori più sofisticati come FreeToken, KTrasformers o AirLLM. Ma soprattutto diviene sempre più importante cominciare a cercare di capire l’architettura interna dei modelli per comprenderne la dinamica di esecuzione e sperimentare con motori che ne efficientano l’esecuzione. Ad esempio, il nuovo Qwen ha un esperto “shared” sempre utilizzato dal modello: per approcci come FreeToken questa è un’ottima notizia perché aumenta la località nella gestione della memoria GPU.
Lo sforzo di guardare un po’ dentro il modello ci consente però di eseguire modelli con capacità dei modelli di frontiera sui nostri sistemi rendendoci un po’ meno dipendenti dai grandi datacenter e dalle infrastrutture che ormai sono accessibili a pochi. Non bisogna però illudersi: non sono framework che possano competere con le grandi infrastrutture se si vogliono realizzare servizi veri con token rate allo stato dell’arte. Resta il fatto che ora possiamo eseguire modelli che fino a pochi mesi fa sembrava impossibile su sistemi più accessibili grazie alla diffusione delle architetture MoE.











Partecipa alla community