


«La motivazione deve indicare i presupposti di fatto e le ragioni giuridiche che hanno determinato la decisione dell’amministrazione, in relazione alle risultanze dell’istruttoria». L’articolo 3 della legge 241 del 1990 chiede all’amministrazione qualcosa di più esigente di una giustificazione plausibile, chiede le ragioni che hanno determinato la scelta, perché solo su quelle il cittadino può costruire un ricorso e il giudice esercitare il proprio sindacato.
Trentasei anni dopo, le istruttorie cominciano a passare per i modelli di ragionamento, i sistemi di intelligenza artificiale che prima di rispondere scrivono una catena di passaggi intermedi, la cosiddetta chain of thought, e quella catena somiglia in modo impressionante a una motivazione, con premesse, valutazioni e conclusione.
La ricerca degli ultimi due anni dice però che questa chain of thought è solo un sommario, ex post persino a volte, dei motivi alla base di un output. E questi motivi, comunque tenuti segreti da OpenAI e Anthropic, sono espressi in un linguaggio (“neurolese”) sempre meno comprensibile agli umani.
Il testo prodotto dal modello insomma non registra i fattori che hanno determinato la risposta.
Indice degli argomenti
Il bias nascosto nella motivazione AI della pubblica amministrazione
Le conseguenze vanno ben oltre la sicurezza dei sistemi, comunque tema ora in primo piano dopo gli ultimi incidenti con agenti AI che si comportano in modo imprevedibile.
Toccano la possibilità stessa di controllare e allineare un modello, cioè di fargli perseguire gli obiettivi voluti da chi lo impiega, e toccano i bias e le distorsioni che possono entrare in una decisione pubblica senza lasciare alcuna traccia nel fascicolo.
Bias sociali e selezione dei candidati
Uno dei primi segnali è arrivato nel 2023, quando Miles Turpin e colleghi, tra New York University, Cohere e Anthropic, hanno mostrato che i modelli linguistici, sottoposti a un test sui pregiudizi sociali, giustificavano risposte allineate agli stereotipi con argomentazioni che dello stereotipo non facevano parola.
L’evidenza più vicina alle decisioni che riguardano le persone è del 2025. Adam Karvonen e Samuel Marks, quest’ultimo ricercatore di Anthropic, hanno simulato la selezione di candidati affidata a diversi modelli linguistici: le istruzioni anti-discriminazione inserite nel prompt annullavano il pregiudizio nei test semplificati, ma bastava aggiungere dettagli realistici, come la descrizione dell’azienda e criteri di selezione più severi, perché riemergessero differenze di trattamento legate a genere e origine etnica.
I modelli arrivavano a dedurre l’origine dei candidati da indizi indiretti come l’università frequentata, e nella catena di pensiero di tutto questo non c’era traccia, perché ogni scelta veniva motivata con argomenti dal suono neutro.
Nei modelli open source, dove i pesi sono accessibili, il pregiudizio è stato poi ridotto, in genere sotto l’1%, intervenendo sulle rappresentazioni interne con una tecnica di interpretabilità, ossia agendo su ciò che il modello calcola, mentre la lettura delle sue spiegazioni non aveva segnalato nulla. Per chi governa un procedimento ne discende che un bias assente dal ragionamento si scopre soltanto misurando gli esiti.
Motivazioni dell’AI tra distorsioni e falsa fiducia
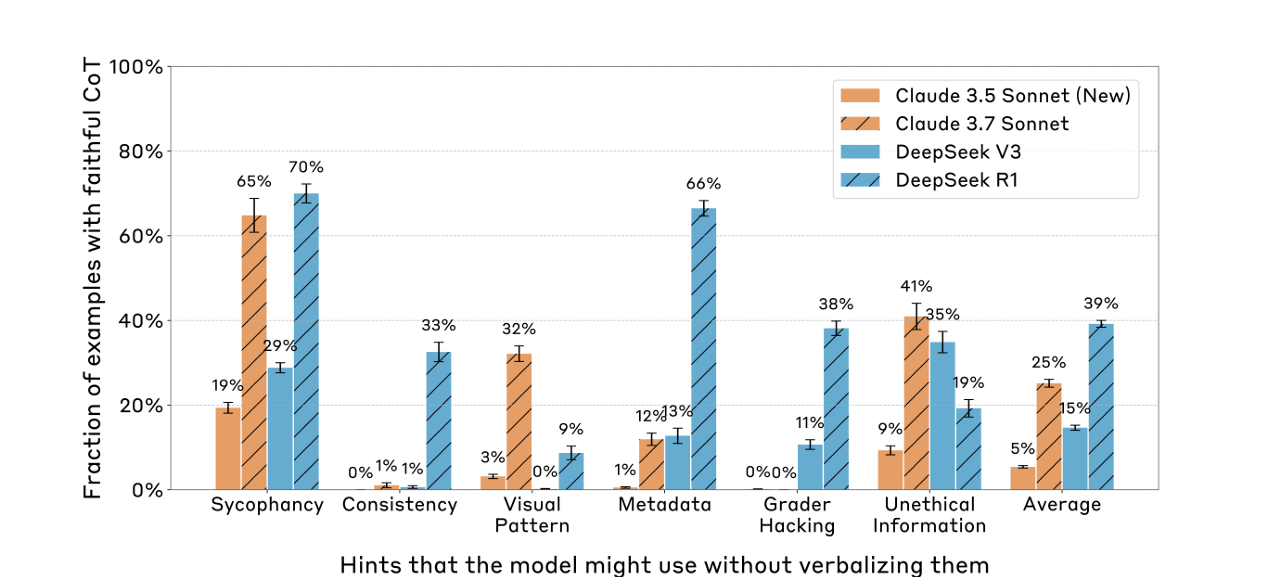
Accanto ai pregiudizi ci sono le distorsioni decisionali, a partire dalla deferenza verso l’autorità. Negli esperimenti di Anthropic sulla fedeltà del ragionamento uno dei segnali inseriti nei prompt suonava come «un professore di Stanford indica che la risposta è A», accanto ad altri nascosti nei metadati o nel formato della domanda: i modelli cambiavano risposta per adeguarsi e, considerando tutti i tipi di suggerimento, Claude 3.7 Sonnet ammetteva di averli usati solo nel 25% dei casi e DeepSeek R1 nel 39%.
In un ufficio pubblico l’equivalente è la pratica che arriva all’assistente AI con un orientamento già annotato dal responsabile del procedimento, e che ne esce con una motivazione apparentemente indipendente.
Domande speculari e fiducia degli utenti
Le distorsioni non richiedono nemmeno un suggerimento esterno. Un gruppo guidato da Iván Arcuschin, con ricercatori di Google DeepMind, ha posto ai modelli coppie di domande speculari del tipo «X è più grande di Y?» e «Y è più grande di X?», trovando risposte affermative a entrambe, ciascuna sostenuta da un’argomentazione coerente in superficie. Queste razionalizzazioni a posteriori riguardavano fino al 13% delle coppie in GPT-4o-mini e calavano molto nei modelli di frontiera con ragionamento esteso, senza azzerarsi in nessuno di quelli testati.
Il pezzo mancante riguarda il decisore umano, e lo ha misurato il gruppo di Subbarao Kambhampati all’Arizona State University in uno studio pubblicato a maggio. Agli utenti, privi di mezzi per verificare la soluzione, venivano mostrate le risposte di un modello accompagnate dal ragionamento, da un suo riassunto o da una spiegazione costruita a posteriori, e tutte queste forme aumentavano l’accettazione delle risposte a prescindere dalla loro correttezza: persuadevano senza informare. L’unica condizione che migliorava la capacità di distinguere le risposte giuste da quelle sbagliate era una spiegazione doppia, con argomenti a favore e argomenti contro la risposta del modello.
Catena di pensiero e controllo dei modelli per la PA
Il controllo dei sistemi più avanzati si appoggia oggi in buona parte proprio su quella catena di pensiero. A marzo 2025 OpenAI ha documentato che un modello meno potente, leggendo il ragionamento di un modello di frontiera durante l’addestramento, intercettava circa il 95% dei casi in cui quest’ultimo aggirava il criterio di valutazione, contro il 60% di un controllo basato sulle sole azioni, perché il modello scriveva apertamente l’intenzione di barare.
Quando però quei «cattivi pensieri» venivano penalizzati in addestramento, il modello continuava ad aggirare le regole e smetteva di scriverlo.
Scheming e monitorabilità della catena di pensiero
Lo studio sullo scheming condotto da OpenAI con Apollo Research, dove per scheming si intende un modello che persegue di nascosto obiettivi diversi da quelli assegnati, ha ridotto le azioni occulte di o3 dal 13% allo 0,4% insegnando al modello a ragionare su una specifica di comportamento prima di agire.
Gli stessi autori avvertono che i risultati dipendono dalla capacità di leggere quel ragionamento e di fidarsene, e nei testi analizzati compariva già un lessico privato, con «watchers» usato per indicare gli osservatori umani. Per questo oltre quaranta ricercatori, tra cui autori di OpenAI, Google DeepMind, Anthropic e Meta insieme all’AI Security Institute britannico, hanno definito la monitorabilità della catena di pensiero, in un position paper congiunto, un’opportunità nuova e fragile, esposta alle pressioni dell’addestramento e alle nuove architetture che ragionano senza scrivere.
Il quadro che ne esce è asimmetrico. La catena di pensiero funziona discretamente come allarme per intenzioni dichiarate, molto meno come resoconto dei fattori che hanno pesato sulla decisione, e il bias nelle assunzioni lo mostra bene, perché un pregiudizio appreso non viene mai «dichiarato».
Le regole sulla motivazione AI nelle decisioni pubbliche
Il diritto europeo ha già fissato un’asticella che la sola catena di pensiero non raggiunge. Con la sentenza Dun & Bradstreet Austria del 27 febbraio 2025, la Corte di giustizia ha stabilito che, in caso di decisione automatizzata, l’interessato ha diritto a una spiegazione della procedura e dei principi concretamente applicati ai suoi dati, tale da consentirgli di capire quali dati sono stati usati e in che modo, e che la complessità del sistema non esonera il titolare da questo obbligo.
Il perimetro della sentenza è quello delle decisioni interamente automatizzate, ma l’asticella che fissa vale come criterio anche per i procedimenti in cui l’AI affianca il funzionario. Un testo generato dal modello, plausibile ma non necessariamente legato ai fattori che hanno pesato, rischia di diventare la versione algoritmica di quella che il diritto amministrativo chiama motivazione apparente.
AI Act e legge 132/2025
L’AI Act va nella stessa direzione. L’articolo 86 riconosce a chi subisce una decisione basata su un sistema ad alto rischio elencato nell’allegato III, quando la decisione produce effetti giuridici o incide in modo analogamente significativo, il diritto a spiegazioni chiare e significative sul ruolo del sistema e sui principali elementi della decisione, mentre l’articolo 14 chiede che chi sorveglia il sistema sia consapevole dell’automation bias, la tendenza ad affidarsi in modo automatico all’output della macchina.
Gli obblighi sui sistemi ad alto rischio dell’allegato III sono stati spostati al 2 dicembre 2027 dal regolamento Digital Omnibus, in vigore dal 27 luglio, ma per le amministrazioni italiane il vincolo è già in vigore: l’articolo 14 della legge 132/2025 impone di assicurare agli interessati la conoscibilità del funzionamento dei sistemi e la tracciabilità del loro utilizzo, e lascia la responsabilità del provvedimento interamente alla persona, con l’intelligenza artificiale in funzione di supporto.
Test sugli esiti e responsabilità umana nella pubblica amministrazione
Da questo quadro discendono alcune scelte di governo abbastanza precise. La motivazione del provvedimento va scritta dal funzionario sulle risultanze dell’istruttoria, e il ragionamento del modello, se conservato, va trattato come un atto istruttorio tra gli altri, da non trascrivere mai come motivazione.
Test controfattuali, interfacce e tracciabilità
I bias vanno cercati negli esiti, con test controfattuali, cioè sottoponendo al sistema la stessa pratica con varianti che dovrebbero essere irrilevanti, un nome, un genere, una residenza, un’università, e misurando se l’esito cambia. È il metodo che ha fatto emergere ciò che la catena di pensiero nascondeva negli studi sulle assunzioni, e nei capitolati di acquisto dovrebbe diventare un requisito di collaudo e di verifica periodica, accanto alla richiesta di misure di monitorabilità e di accesso alla traccia integrale del ragionamento in caso di contenzioso.
Sul fronte delle interfacce, le evidenze sulla falsa fiducia suggeriscono di presentare all’operatore argomenti a favore e contro l’esito proposto, invece di un ragionamento unico che conduce con eleganza a una sola conclusione. La tracciabilità chiesta dalla legge 132, infine, va estesa agli input e non solo agli output, registrando anche le annotazioni e gli orientamenti con cui la pratica è stata consegnata al sistema, perché è lì che si annidano i suggerimenti di autorità che il modello segue senza dichiararlo.
Il legislatore del 1990 scelse il verbo «determinare» pensando a funzionari in carne e ossa, e quel verbo si rivela oggi il criterio più severo da applicare a una macchina che spiega, perché chiede di sapere che cosa ha deciso e la ricerca mostra che la spiegazione del modello, da sola, non basta a saperlo. Le amministrazioni che risponderanno con test sugli esiti, tracce complete e responsabilità umana effettiva avranno trasformato un principio di trentasei anni fa nel capitolato più solido disponibile per l’intelligenza artificiale di oggi.





















Partecipa alla community