


Sono riuscito ad avere un primo portatile, un Surface laptop ultra con 64GB di memoria condivisa, con il nuovissimo RTX Spark, la piattaforma annunciata pochi mesi fa da Huang e Nadella che promette di eseguire modelli AI localmente anche sul proprio portatile. Si tratta di una piattaforma analoga alla GB10 della DGX Spark, la piccola workstation da desktop capace di eseguire modelli di oltre 120B in locale, ma è naturale chiedersi come la potenza di calcolo richiesta si adatti al formato di un laptop e soprattutto come si comporta la batteria quando si usano modelli AI locali.
Indice degli argomenti
AI locale sui laptop: Windows ARM, batteria e stabilità
Avevo già avuto modo di sperimentare la maturità dell’implementazione di Windows su processori ARM per cui non dubitavo del funzionamento del sistema operativo di Redmond, ma dopo poco meno di una settimana di uso di questo nuovo portatile posso confermare che la piattaforma è assolutamente matura anche quando si installano software legacy compilati per x86, inclusi alcuni driver.
Si tratta di laptop abbastanza pesanti: l’impressione che si ha è che la batteria (e l’alimentatore da 140W) sia pensata per assicurare una durata ragionevole anche quando si fa uso di tutta la potenza di calcolo a disposizione.
Architettura RTX Spark N1X e memoria condivisa
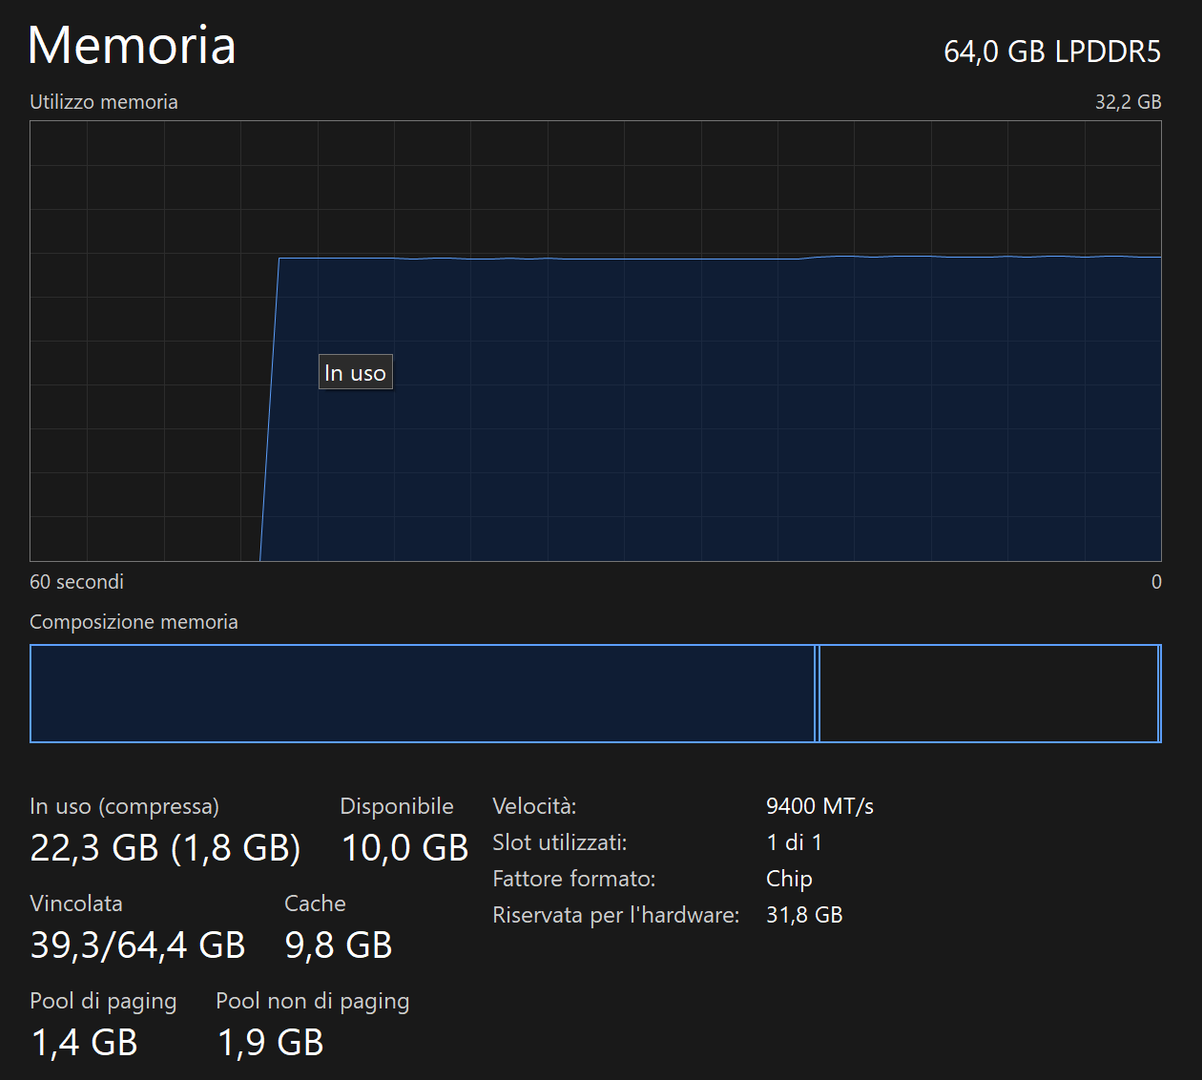
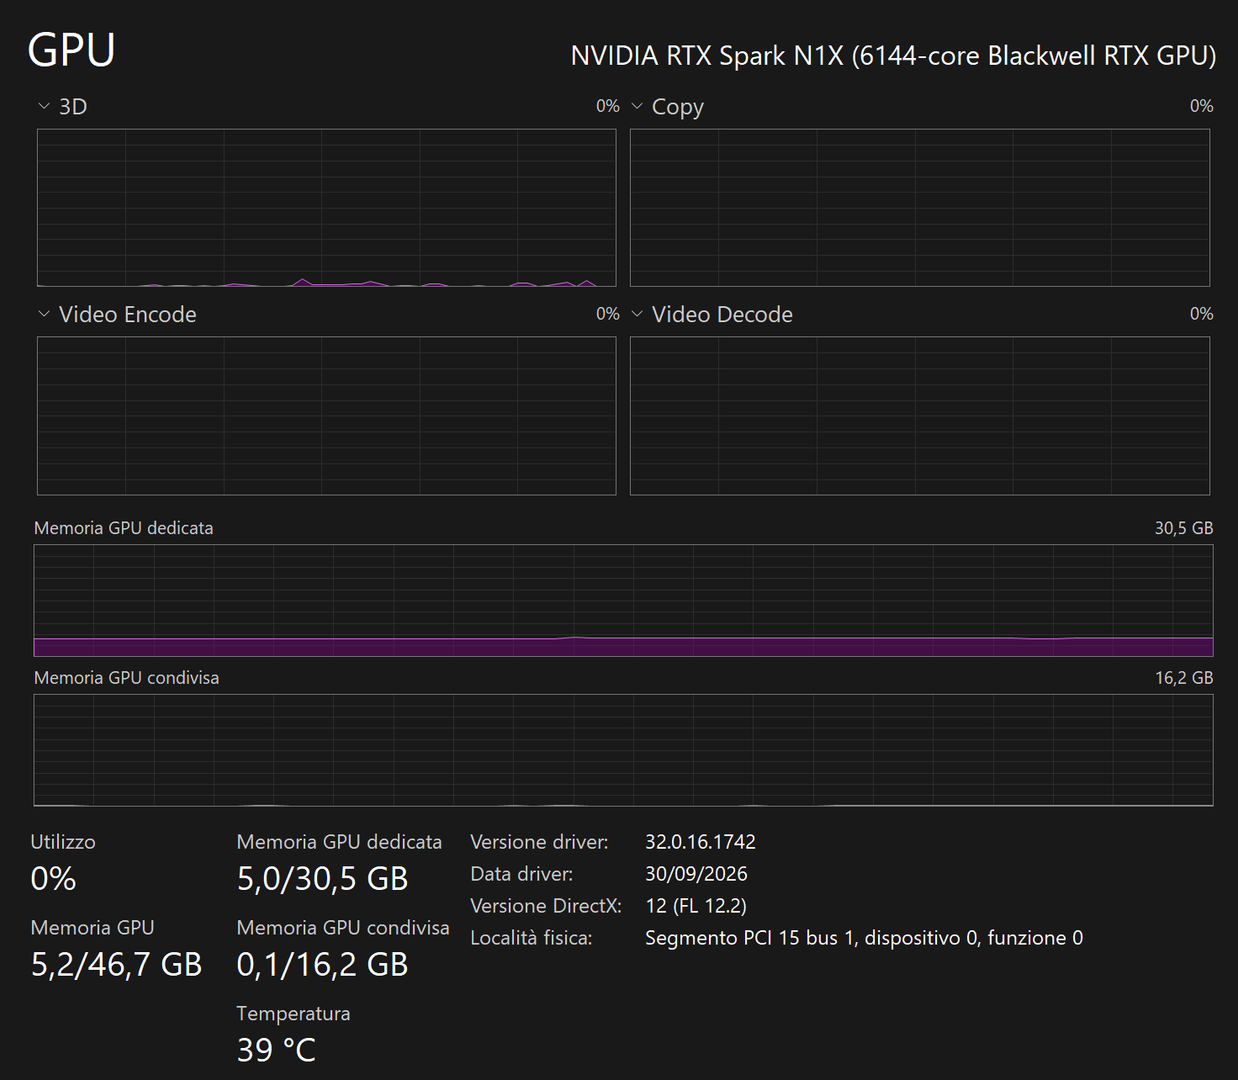
La piattaforma ha 20 core ARM Grace e 6144 Cuda core Blackwell con 64GB (in effetti ne esistono due versioni di RTX Spark N1X, quella che uso ed una con 18 core Grace e 5120 core Blackwell per le configurazioni con meno memoria. La memoria è condivisa come nell’architettura GB10 del DGX Spark e sta al sistema operativo orchestrarne l’allocazione tra parte GPU e parte CPU.
Quindi il fatto che la mia unità abbia 64GB di RAM condivisa non significa che Windows li usi tutti, nel task manager si vede chiaramente come una quota variabile della memoria sia vincolata alla GPU per assicurare il corretto funzionamento.
L’impressione è che nVidia e Microsoft abbiano lavorato molto per assicurare la migliore integrazione possibile delle funzioni del chip all’interno del sistema operativo, e come vedremo a breve credo di aver anche incontrato configurazioni di software che non riescono a sfruttare appieno l’hardware.
RTX Spark N1X e le prestazioni dell’AI locale sul laptop
Non appena configurato il sistema ho installato ollama per eseguire modelli AI localmente più grandi di quelli che solitamente posso permettermi di eseguire sul laptop. Non sono riuscito ad eseguire GPT-OSS 120B (uno dei miei modelli preferiti) ma i modelli fino a 50B si riescono ad eseguire e sono modelli decisamente capaci a cui affidare compiti localmente.
Modelli AI locali fino a 50B e autonomia
Anche se non ho condotto benchmark nel senso scientifico del termine l’impressione che ho avuto da alcuni test condotti è che la piattaforma sia paragonabile se non leggermente superiore alla GB10, e questo è sicuramente un aspetto molto importante perché non era assolutamente ovvio che il formato laptop, con requisiti completamente differenti in termini di alimentazione, potesse garantire le stesse prestazioni di una workstation.
L’esecuzione di modelli anche molto grandi, come gemma4 con 31B, non hanno mostrato di scaricare la batteria in modo drammatico come avveniva sui miei laptop precedenti, certo ci si accorge che si stanno usando più risorse ma la sensazione non è quella di un sistema che se usi un modello grande sta acceso solo cinque minuti.
E anche l’uso di modelli grandi dà l’impressione finalmente di poter disporre dell’AI sul proprio sistema in modo credibile. Credo sia la prima volta da quando scrivo di AI generativa che mi trovo a ritenere che finalmente siamo arrivati ad un momento in cui l’AI locale sia davvero pronta, per svolgere alcuni compiti. Certo i grandi modelli restano assolutamente più capaci ma quelli locali assomigliano a quelli di frontiera di poco più di un anno fa. Sono addirittura riuscito ad usare due modelli contemporaneamente: uno decisionale ed un LLM grande.
OpenClaw e AI locale tra Windows e sottosistema Linux
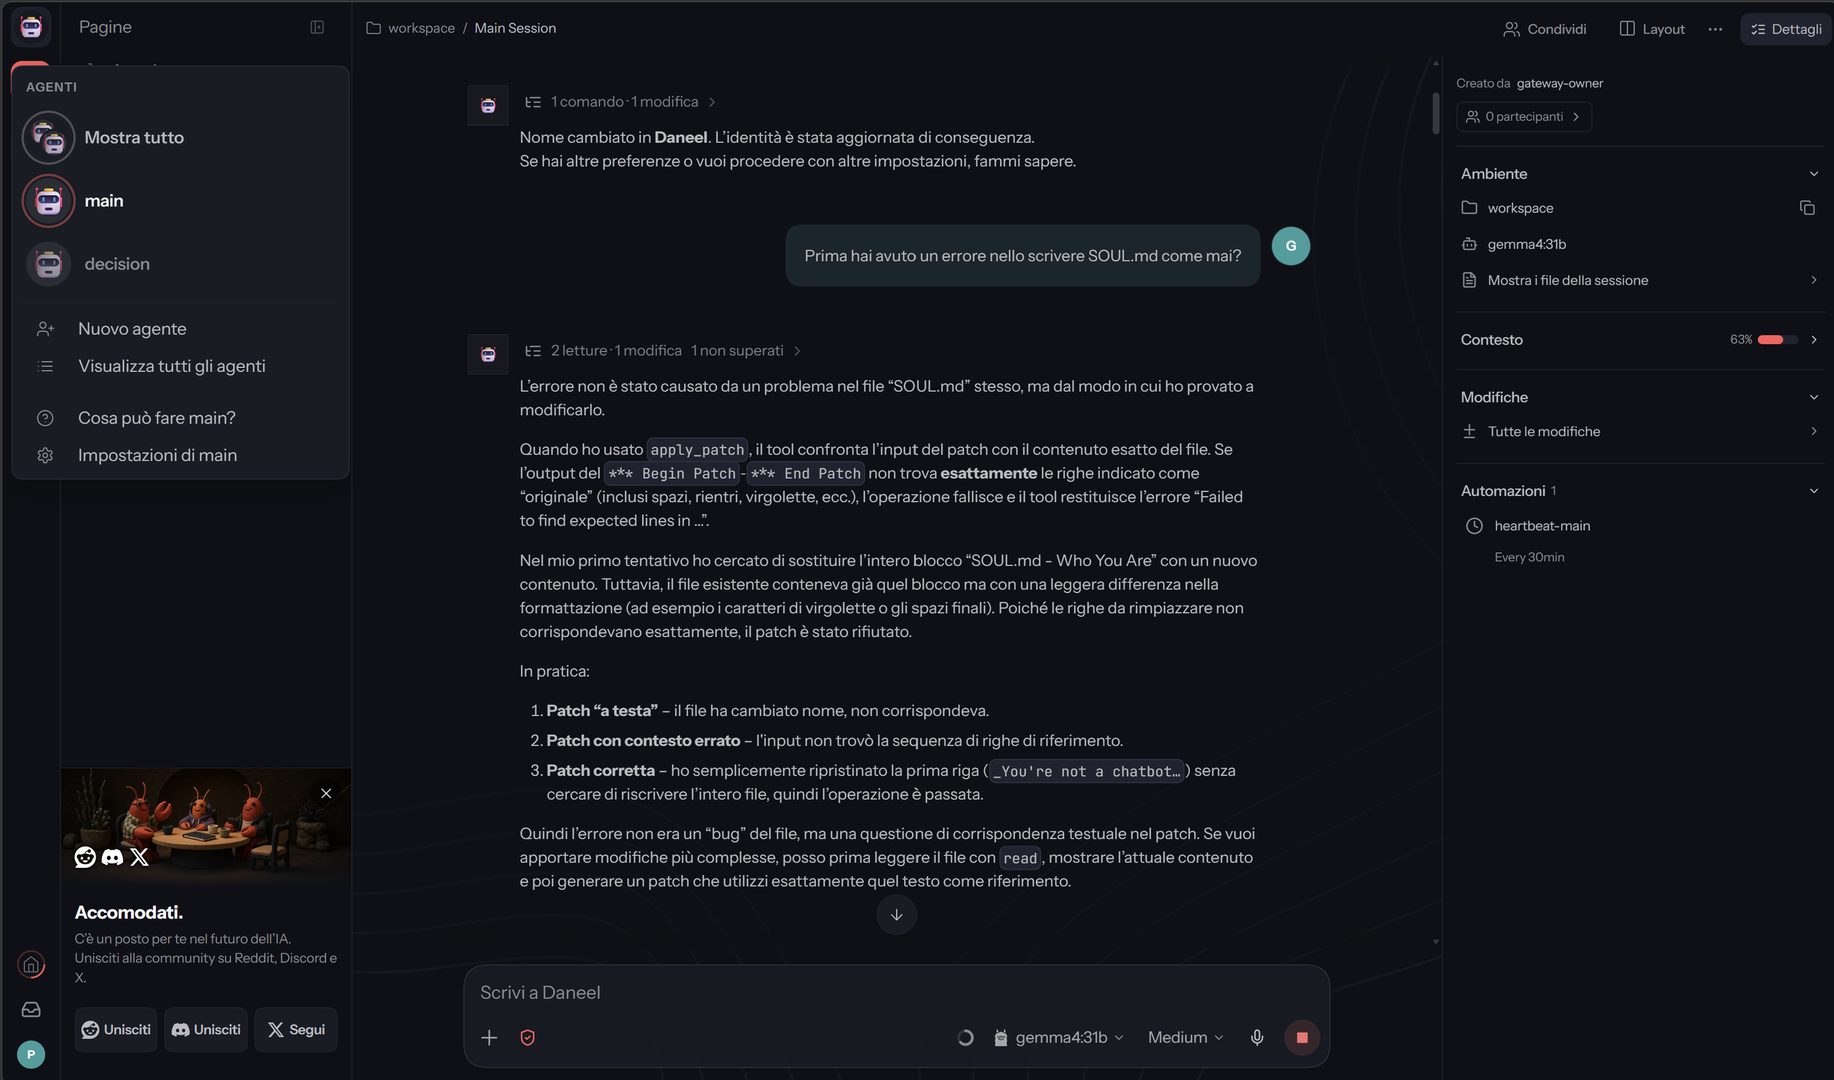
Dopo aver giocato un po’ con ollama e la sua interfaccia locale sono passato ad installare OpenClaw sulla macchina. Visto che OpenClaw non assicura che l’agente non faccia danni ho deciso di installarlo sul sottosistema Linux di Windows (come per altro è raccomandato) e istintivamente durante il primo tentativo ho anche installato ollama dentro lo stesso sottosistema nella convinzione di avere un ambiente isolato su cui provare.
Dopo pochi tentativi ho però scoperto che quando ollama esegue all’interno del sottosistema linux non riesce ad utilizzare correttamente le capacità dello Spark N1X e le prestazioni che ottenevo erano assolutamente inaccettabili rispetto a quelle misurate con l’esecuzione di ollama su Windows.
Ho quindi condiviso la rete del sottosistema Linux configurando la modalità mirrored nel file %UserProfile%\.wslconfig e consentendo l’uso di ollama in esecuzione su Windows all’installazione OpenClaw su linux.
Agenti AI locali: possibilità e limiti dei modelli
Grazie alla grande disponibilità di risorse sono riuscito a configurare due agenti che fanno uso di modelli differenti: uno che usa un LLM come GPT-OSS 20B o Gemma4 31B, e l’altro che usa un modello decisionale come clef-flash. L’idea che avevo era quella di sfruttare un modello decisionale per prendere decisioni su richiesta così che i miei agenti potessero usarlo come strumento, ma nessuno dei modelli che ho provato è stato capace di invocare correttamente l’endpoint con il formato JSON richiesto dal modello di decisione.
GPT inventava i messaggi, Gemma4 si è avvicinato di più ma comunque non è riuscito nel compito. Si tratta di un compito che i modelli di frontiera risolvono agilmente e credo che sia un memento al fatto che anche se un’infrastruttura AI locale si comporta in modo simile ad una online non è assolutamente vero che ne abbia le stesse capacità.
L’AI locale sui laptop dalla promessa alla realtà
L’esperienza di disporre di quello che fino a pochi mesi fa era un server all’interno del mio laptop è sicuramente interessante ed apre nuove possibilità alle attività che posso svolgere localmente grazie ai modelli open weight. Per ora la piattaforma Spark N1X non è certo orientata al modello consumer, ma il costo di un laptop è sostenibile in un contesto aziendale, e la possibilità di lavorare con AI almeno in parte localmente credo che sia un’opportunità da non perdere.
Ero scettico sulla durata della batteria, ma almeno su questo Surface Laptop Ultra dopo oltre 20 minuti di lavoro di OpenClaw con due modelli avevo consumato meno del 20% di batteria.
Mi sembra che tutto indichi che l’AI locale sui laptop non sia più solo una promessa ma una realtà, anche se solo ai primi passi.




























Partecipa alla community