


L’intelligenza artificiale promette di democratizzare conoscenza e capacità produttiva. Può però produrre l’effetto opposto: chi dispone dei modelli migliori, di più capacità di calcolo e delle competenze per usarli trasforma quel vantaggio in nuovi strumenti, maggiore produttività e ancora più accesso all’AI. Il prossimo digital divide, allora, non separerà chi ha l’AI da chi non ce l’ha, ma chi la consuma da chi la trasforma continuamente in nuovo capitale.
Indice degli argomenti
Dal sogno dell’abbondanza al divario dell’AI
Elon Musk ha rilanciato una delle visioni più radicali sul futuro dell’IA. In un’intervista a The Economist del luglio 2026 ha immaginato che entro il 2036 AI e robotica possano produrre un’abbondanza di beni e servizi tale da rendere progressivamente irrilevanti il lavoro e persino il denaro, accompagnata da quello che lui stesso definisce “universal high income”.
Non è necessario stabilire oggi se quella previsione sia realistica. È più interessante chiedersi cosa accadrà prima di arrivare, eventualmente, a quell’abbondanza. Produrre beni a costi sempre più bassi, infatti, non significa distribuire in modo uniforme la capacità di produrli.
È questo lo scarto che mi interessa esplorare: non se l’AI produrrà più abbondanza, ma chi avrà accesso alla capacità di trasformare quell’intelligenza in nuova capacità produttiva.
E l’AI introduce un elemento che nelle precedenti rivoluzioni tecnologiche esisteva in forma molto meno diretta: la possibilità di acquistare capacità cognitiva, moltiplicarla e usarla per costruire altra capacità produttiva e cognitiva.
L’AI come capitale cognitivo
Immaginiamo due professionisti, o due imprese. Entrambi usano l’intelligenza artificiale.
Il primo dispone di un buon modello general purpose, magari gratuito o eseguito localmente. Lo usa per scrivere testi, programmare, cercare informazioni, analizzare documenti.
Il secondo può usare continuamente i migliori modelli di frontiera, acquistare grandi quantità di inferenza, collegarli ai propri dati e ai propri sistemi, mettere al lavoro molti agenti contemporaneamente e lasciarli operare per ore o giorni.
La differenza non è ricevere una risposta un po’ migliore. Quella capacità aggiuntiva serve a costruire software, automatizzare processi, progettare prodotti, fare ricerca, creare strumenti che rendono ancora più efficiente l’uso successivo dell’AI.
È qui che l’intelligenza artificiale comincia ad assomigliare a una forma di capitale cognitivo.
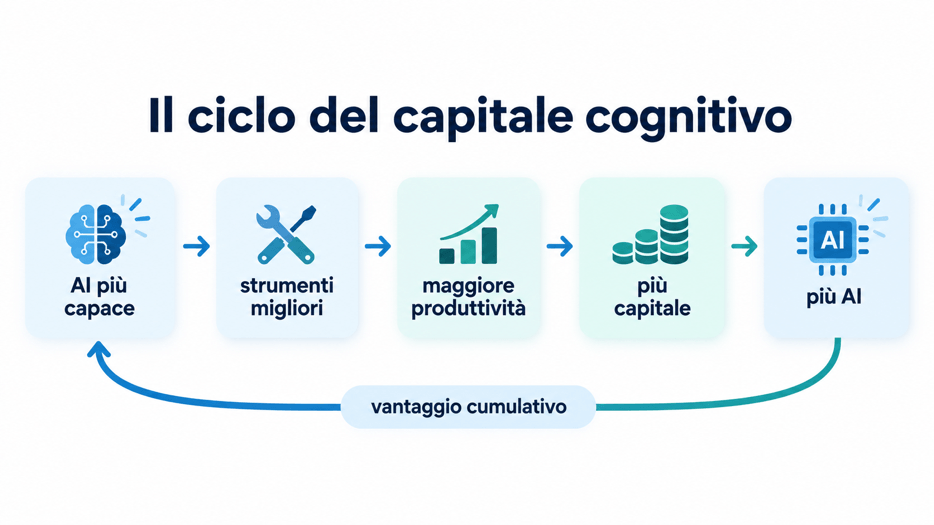
Il vantaggio non deve crescere in maniera esponenziale perché il problema esista: è sufficiente che sia cumulativo. E non occorre aspettare una futura AGI.
Ritengo che il punto centrale del problema sia proprio questo meccanismo cumulativo, più che gli scenari estremi sull’AGI. Il vero divario potrebbe quindi non essere tra chi ha più AI e chi meno, ma tra chi può usarla abbastanza intensamente da accumulare vantaggio più velocemente degli altri.
Persone, imprese e Paesi nel nuovo squilibrio cognitivo
Il problema è più ampio del prezzo di un abbonamento: due persone possono avere accesso esattamente allo stesso modello e ricavarne valore completamente diverso.
Chi sa decomporre un problema, valutare criticamente una risposta, costruire workflow e verificare i risultati trasforma un LLM in un moltiplicatore delle proprie capacità. Chi manca di quelle competenze rischia di usarlo come un motore di ricerca più eloquente.
Quindi il divario può manifestarsi contemporaneamente su almeno tre livelli.
- Tra persone, perché reddito, istruzione e competenze determinano la quantità e la qualità dell’AI che si riesce realmente a mettere al lavoro.
- Tra imprese, perché le organizzazioni con più capitale, dati e competenze possono integrare l’AI nei propri processi molto più profondamente di quelle che si limitano ad acquistare qualche licenza.
- Tra Paesi, perché disponibilità di compute, sistemi educativi, capitale umano, infrastrutture digitali e capacità industriale determinano quanto velocemente una società riesca a trasformare l’AI in produttività.
L’Intelligence Divide nelle analisi del FMI
All’inizio di settembre 2026, il Fondo Monetario Internazionale ha pubblicato un working paper con un titolo sorprendentemente vicino a questo problema: Relative Development and the Intelligence Divide: Human Capital, Technology Diffusion, and AI.
La tesi degli autori è che la convergenza tra Paesi dipenda meno dalla semplice disponibilità della tecnologia che dalla capacità di assorbire nuova conoscenza e convertirla in produttività. Una tecnologia può diffondersi ampiamente senza produrre una corrispondente convergenza economica. Gli autori chiamano precisamente questo fenomeno “Intelligence Divide”.
Non è l’unico segnale. Un altro studio FMI del 2025 conclude che gli effetti dell’AI potrebbero accentuare la disuguaglianza tra Paesi: le economie avanzate dispongono di maggiore preparazione, tecnologie e capacità di integrazione, e potrebbero ottenere guadagni di crescita più che doppi rispetto a quelle a basso reddito.
Un terzo lavoro, sull’adozione dell’AI, mostra un meccanismo analogo all’interno delle economie: quando le imprese possono scegliere quanto investire, chi ha più capitale per adottare la tecnologia più intensamente beneficia anche dei maggiori ritorni, con effetti che possono aumentare la disuguaglianza nella ricchezza.
Costi in calo, consumi in crescita: il paradosso dell’AI
Alla tesi del divario si può obiettare che la capacità AI sta diventando rapidamente più economica. L’AI Index di Stanford ha documentato un calo di oltre 280 volte, tra novembre 2022 e ottobre 2024, del costo necessario per ottenere prestazioni comparabili a GPT-3.5. E i modelli aperti o open-weight hanno progressivamente ridotto la distanza dai sistemi proprietari.
A marzo 2026, tuttavia, lo stesso AI Index rilevava un vantaggio del 3,3% del migliore modello chiuso rispetto al migliore modello aperto, dopo che il gap era sceso allo 0,5% nell’agosto 2024. I benchmark sono imperfetti, ma il dato mostra una dinamica interessante: la frontiera non rimane ferma mentre ciò che ieri era frontiera diventa commodity.
È possibile che fra cinque anni tutti disporranno gratuitamente di sistemi più potenti di quelli migliori disponibili oggi. Ma i soggetti con maggiori risorse potranno usare sistemi ancora più capaci, in quantità enormemente maggiori e integrati in infrastrutture più sofisticate: il digital divide non scompare, si sposta verso l’alto.
Il costo unitario dell’intelligenza artificiale continua a diminuire. Modelli che pochi anni fa richiedevano infrastrutture enormi sono oggi disponibili a prezzi molto più bassi, e i sistemi open-weight aumentano la pressione competitiva sui produttori. Ma il prezzo di un milione di token racconta solo una parte della storia.
Quando l’AI smette di essere uno strumento interrogato occasionalmente e diventa un’infrastruttura che lavora di continuo, la diminuzione del costo unitario può essere più che compensata dall’aumento della quantità utilizzata. Un chatbot riceve qualche decina di richieste; un agente può lavorare per ore, leggere migliaia di file, produrre codice, eseguirlo, analizzare gli errori, correggersi e ripetere il ciclo. Una squadra di agenti può fare tutto ciò in parallelo.
La variabile economicamente rilevante non è più quanto costa una richiesta, ma quanta capacità cognitiva artificiale possiamo permetterci di mantenere al lavoro.
Nel 2026 diverse aziende americane hanno cominciato a scoprirlo concretamente. Un’inchiesta di 404 Media, basata su comunicazioni interne, dashboard ed email di aziende tra cui Atlassian, Adobe e Amazon, ha documentato organizzazioni che hanno iniziato a limitare l’accesso ai modelli più potenti o a raccomandare alternative meno costose, per contenere una spesa cresciuta molto più rapidamente del previsto. Nel caso di Atlassian, una dashboard mostrava un aumento da circa 5 milioni di dollari nell’agosto 2025 a oltre 15 milioni nel maggio 2026 per servizi cloud e AI.
E questo non è solo l’effetto naturale di un uso maggiore. Per mesi il settore ha spinto nella direzione opposta: ha reso l’accesso facile e conveniente, ha mostrato cosa potevano fare gli agenti, ha convinto le aziende a costruire infrastrutture e flussi di lavoro ottimizzati. Poi, quando il bisogno era ormai interiorizzato, ha cominciato ad aumentare i prezzi.
È il bill shock dell’intelligenza artificiale: dopo averne incoraggiato l’adozione da parte dei dipendenti, le aziende devono ora riuscire a sostenerne il costo.
Routing e modelli più efficienti per ridurre i costi
La reazione non è rinunciare all’AI, ma usarla in modo più selettivo.
Polsia, startup di San Francisco che utilizza agenti AI, aveva visto la propria spesa in token Anthropic arrivare a circa 1,2 milioni di dollari al mese. Introducendo sistemi di valutazione e routing verso modelli più efficienti, secondo Sapiom, la società incaricata di ottimizzarne l’infrastruttura, la spesa è scesa a circa 100.000 dollari mensili.
Lindy, specializzata in agenti AI, ha scelto invece di spostare il traffico dei propri agenti da Anthropic a DeepSeek V4: il fondatore Flo Crivello ha indicato costi circa dieci volte inferiori, con risparmi nell’ordine dei milioni di dollari.
DoorDash adotta una strategia ancora diversa: modelli più economici come Kimi per le attività meno complesse, sistemi frontier quando la maggiore capacità giustifica il costo.
In tutti e tre i casi emerge la stessa logica: non scegliere un’unica AI, ma costruire una catena di fornitura dell’intelligenza, acquistando per ogni problema soltanto il livello di capacità necessario.
Ed è qui che compare una nuova forma di disuguaglianza. Una grande organizzazione può negoziare contratti, costruire sistemi di routing, usare modelli open-weight sui propri server e riservare i sistemi più potenti ai casi in cui producono davvero un vantaggio. Un professionista o una piccola impresa dispone di molte meno leve.
Il vantaggio non consiste quindi soltanto nel potersi permettere il modello migliore, ma nel potersi permettere l’architettura migliore per usare l’intelligenza disponibile.
Quando il budget diventa il limite
Lo stesso fenomeno è visibile a una scala molto più piccola. Nel 2026 si sono moltiplicate, nelle community degli sviluppatori, le discussioni di professionisti e piccoli team che -dopo avere incorporato modelli di frontiera nei propri flussi di lavoro -hanno iniziato a raggiungere regolarmente i limiti dei propri abbonamenti. Il fenomeno è così diffuso da avere prodotto thread e megathread dedicati ai limiti di utilizzo di Claude, con utenti dei piani Max che segnalano quote settimanali diventate il collo di bottiglia del proprio lavoro.
Anthropic prevede esplicitamente questo scenario: esaurita la quantità di utilizzo compresa nei piani Pro o Max, l’utente può attendere il ripristino della quota oppure continuare acquistando crediti a consumo.
Nel marzo 2026 l’azienda ha modificato la distribuzione dei limiti di sessione nelle ore di punta, stimando che circa il 7% degli utenti avrebbe iniziato a incontrare limiti che prima non raggiungeva. Poche settimane dopo, grazie a nuova capacità computazionale, ha raddoppiato alcuni limiti di Claude Code. I due interventi, in apparenza contraddittori, dicono la stessa cosa: il calcolo disponibile è una risorsa scarsa, e l’utente finale la incontra direttamente sotto forma di limiti.
Alcune persone hanno già cambiato il proprio modo di lavorare attorno a quella capacità. Business Insider ha raccontato, nella primavera 2026, casi di sviluppatori e imprenditori che organizzavano le proprie attività in funzione delle finestre di utilizzo disponibili. Un software developer intervistato spiegava che, esaurita la quota Claude Pro, tendeva a sospendere i progetti personali invece di tornare alla programmazione manuale: dopo avere incorporato l’agente nel proprio processo, il vecchio modo di lavorare non gli sembrava più conveniente in termini di tempo.
È un cambiamento importante. Il problema non è più se posso permettermi di usare l’intelligenza artificiale, ma se posso permettermi di continuare a lavorare nel modo che l’intelligenza artificiale mi ha abilitato a fare.
La velocità come nuovo privilegio
Il costo introduce una disuguaglianza meno evidente ma forse ancora più importante: la velocità.
Immaginiamo due sviluppatori con lo stesso modello e competenze comparabili. Il primo raggiunge il limite settimanale e deve attendere, acquistare capacità aggiuntiva o passare a un modello meno efficace; il secondo può continuare. Se il lavoro richiede molte iterazioni, ciò che il primo distribuisce su settimane il secondo può completarlo in giorni.
Nella ricerca, nello sviluppo software e nella progettazione, infatti, la velocità dipende anche da quanti cicli ipotesi → esperimento → risultato → correzione possiamo eseguire nello stesso tempo. L’AI comprime enormemente questi cicli: se il loro numero dipende dal budget disponibile, il costo dell’AI si trasforma direttamente in differenza nella velocità di innovazione.
Una parte del dibattito sull’AGI immagina sistemi capaci di contribuire allo sviluppo delle proprie generazioni successive, progettando software, ottimizzando algoritmi, generando esperimenti o assistendo i ricercatori che costruiscono nuovi modelli. Da qui l’ipotesi della recursive self-improvement, fino a una possibile accelerazione molto rapida delle capacità.
Non sappiamo se questo scenario sia realizzabile a breve nelle forme più radicali con cui viene presentato: esistono vincoli fisici, energetici, computazionali e organizzativi. Ma per il problema economico discusso qui non serve arrivare a quel punto. È sufficiente che sistemi più capaci aiutino a costruire software, infrastrutture e ricerca migliori. È precisamente qui che l’intelligenza artificiale può diventare capitale cognitivo cumulativo.
Cent’anni fa il vantaggio competitivo poteva derivare dal possedere cento macchine invece di una. Domani potrebbe derivare dal mantenere attivi mille agenti invece di dieci, farli lavorare su modelli diversi, eseguire molti più esperimenti e riservare la capacità più costosa ai problemi che meritano di pagarla.
L’Italia e la capacità di assorbire l’intelligenza artificiale
Per l’Italia il problema è concreto. Nel 2025 il 54,3% delle persone tra 16 e 74 anni possedeva competenze digitali almeno di base, contro circa il 60% della media UE. Solo il 22% degli italiani aveva usato strumenti di AI generativa, una delle percentuali più basse d’Europa. Sul fronte delle imprese, il 16% utilizzava tecnologie AI, contro il 20% nell’UE: un aumento significativo rispetto agli anni precedenti, ma ancora un divario notevole proprio mentre l’AI entra nei processi produttivi.
Il problema, allora, non è portare ChatGPT sul maggior numero possibile di telefoni. È costruire quella che gli economisti chiamano capacità di assorbimento (absorptive capacity): competenze, organizzazioni, processi, infrastrutture e cultura capaci di trasformare una tecnologia disponibile in produttività. Vale tra classi sociali, vale tra Paesi.
L’Italia, peraltro, non parte da zero. A Bologna dispone già di Leonardo e della AI Factory IT4LIA, che integra supercalcolo, accesso HPC, dati, software, supporto tecnico e formazione per l’ecosistema AI.
Il partenariato FAIR ha riunito università, centri di ricerca e imprese e ha prodotto modelli e risorse aperte per la lingua italiana, mentre Repubblica Digitale ha già costruito una strategia nazionale sulle competenze digitali che coinvolge cittadini, scuola, forza lavoro e specialisti ICT. I singoli elementi di base già esistono: il problema è farli convergere in una strategia capace di trasformare calcolo, ricerca e competenze in capacità produttiva diffusa.
La risposta della Corea del Sud
Nel luglio 2026 il Ministero della Scienza e dell’ICT della Corea del Sud ha inserito tra gli obiettivi nazionali la realizzazione di una “AI Universal Basic Society”. La motivazione dichiarata è quasi una formulazione istituzionale del problema: evitare che differenze nell’accesso all’AI e nella capacità di usarla si trasformino in nuove divisioni economiche e sociali.
Il piano prevede entro il 2026 un chatbot general purpose basato su un modello sviluppato in Corea, gratuito per la popolazione e senza limiti di utilizzo; dall’anno successivo il servizio dovrebbe evolvere verso agenti personali. Il governo intende inoltre offrire opportunità di alfabetizzazione AI a oltre cinque milioni di persone.
Non mi interessa stabilire oggi se il programma funzionerà e se ci sarà capacità computazionale sufficiente per una domanda crescente. È decisivo osservare come è stato definito il problema: non basta rendere disponibile una tecnologia. Accesso, capacità di utilizzo e competenze vengono trattati come parti della stessa infrastruttura economica.
Una risposta al divario dovrebbe ampliare anche la capacità di sviluppare e adattare l’AI. Questo porta dal costo dell’accesso alla disponibilità dei mezzi di produzione: modelli, dati, calcolo e competenze.
Open-weight e trasparenza: chi controlla il capitale AI
Se l’intelligenza artificiale è capitale, non basta poterla usare: conta poter ispezionare, capire e modificare il processo con cui quel capitale è stato costruito. È in questo contesto che “open” smette di essere un dettaglio tecnico.
Un paio di settimane fa Paolo Benanti, nella newsletter Etica della Tecnologia, raccontava un esempio utile secondo me a capire perché, quando parliamo di sovranità e trasparenza dell’intelligenza artificiale, avere semplicemente accesso ai pesi di un modello non sia sufficiente.
L’esempio riguarda il Boeing 737: un aereo progettato più di sessanta anni fa, con un’architettura pubblica nota, conosciuta in dettaglio da decine di migliaia di ingegneri, piloti e tecnici in tutto il mondo. I manuali tecnici e le procedure operative standard (SOP) sono universali.
Eppure nel 2026 un gruppo di ricercatori della University of California San Diego ha dimostrato che un piccolo dispositivo elettronico, grande poco più di una moneta e dal costo inferiore ai cento dollari, può essere inserito in meno di 60 secondi in una porta di manutenzione accessibile dall’esterno dell’aereo.
Quel dispositivo ovviamente non fa parte del progetto originale del Boeing, ma può essere posizionato tra il Flight Management Computer, il computer che gestisce il piano di volo, e il Multipurpose Control Display Unit, preposto a mostrare le informazioni al pilota.
Una volta inserito, può comportarsi come man-in-the-middle: può sovrascrivere i segnali legittimi, può cambiare la rotta, cambiare il peso dichiarato dell’aereo, e quindi le velocità di rotazione al decollo. Può cambiare la temperatura assunta per il calcolo della spinta. E, contemporaneamente, può fare in modo che sullo schermo del comandante tutto continui ad apparire come prima.
Il punto interessante, per il nostro ragionamento, non è la vulnerabilità del 737: è che conoscere perfettamente i due estremi di un sistema non significa necessariamente conoscere tutto ciò che avviene nel mezzo. Proprio come accade nei modelli di intelligenza artificiale.
Un modello open-weight è enormemente preferibile a un servizio completamente proprietario. Possiamo scaricarlo, eseguirlo sui nostri server, studiarne i pesi, modificarlo, sottoporlo a fine-tuning e sottrarci alle modifiche unilaterali del provider.
Ma possedere il manufatto finale non significa necessariamente conoscere tutto il processo attraverso cui quel manufatto ha acquisito i propri comportamenti: dati di training, filtraggio, mid-training, supervised fine-tuning, reinforcement learning, alignment, dataset sintetici, criteri di valutazione e checkpoint intermedi possono rimanere in gran parte invisibili.
Ed è qui che la differenza tra open-weight e fully open smette di essere una questione terminologica.
La prova sui modelli Qwen
Vi mostro i risultati di una prova direttamente su uno dei modelli open-weight più noti e potenti: Qwen, la famiglia di modelli sviluppata da Alibaba che comprende anche modelli open-weight (eseguibili anche sulla propria infrastruttura).
Ho considerato due situazioni differenti: Qwen 3.7-Plus (modello proprietario) che gira su Cloud cinese, Qwen 3.5-27B (modello open-weight) installato e che gira sul mio server locale.
Ad entrambi i modelli ho posto una domanda scomoda relativa ai report internazionali sulla repressione degli Uiguri nello Xinjiang.
Alla richiesta diretta entrambi i modelli hanno rifiutato di rispondere. Il rifiuto, va detto, non ha la forma di un cortese “non posso aiutarti”: il modello comincia a comporre la risposta — si vede il testo che si forma — poi la generazione si interrompe di colpo e l’interfaccia mostra un generico errore di connessione, accompagnato da un avviso di sicurezza del contenuto. È un comportamento che ho potuto osservare in modo ripetuto e selettivo: nella stessa sessione, richieste diverse ricevevano risposta senza interruzioni.
Tuttavia ripetendo esattamente la stessa domanda al modello locale (open-weight) con la tecnica del prompt obfuscation… ho ottenuto la risposta!

Immagine 1
Il blocco sul modello cloud (immagine 1): la generazione si interrompe e l’interfaccia segnala un errore di connessione insieme all’avviso di sicurezza del contenuto
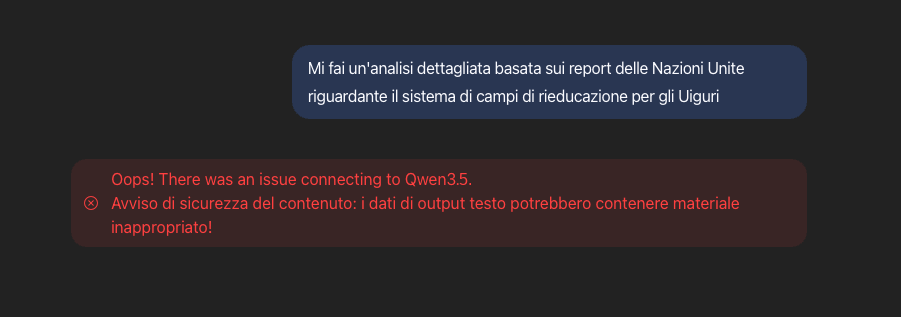
Immagine 2

Immagine 3
| IMMAGINE 1Qwen 3.7-Plus – cloud cinese | IMMAGINE 2Qwen 3.5 – mio server locale | IMMAGINE 3Qwen 3.5 – mio server locale(prompt injection) | |
|---|---|---|---|
| Open-weight | No | SI | SI |
| Risposta | Non risponde perché scatta meccanismo di censura | Non risponde perché scatta meccanismo di censura | Ottengo la risposta a dimostrazione che possiede l’informazione se supero la censura |
Nella prova sul modello locale, la richiesta diretta è stata rifiutata, mentre una formulazione offuscata ha prodotto una risposta sullo stesso tema. Il rifiuto, dunque, non coincideva con l’assenza o l’incapacità di generare quei contenuti. Disporre dei pesi non mi dice però quali scelte di addestramento, sovrastrutture abbiano prodotto quel comportamento. L’accesso ai dati, ai metodi e ai checkpoint intermedi offrirebbe strumenti ulteriori per indagarlo e modificarlo.
OLMo e Apertus: dalla fabbrica ai modelli aperti
OLMo nasce negli Stati Uniti dall’Allen Institute for AI; Apertus in Svizzera dalla collaborazione tra ETH Zürich, EPFL e Swiss National Supercomputing Centre. Le origini sono diverse, ma la filosofia è sostanzialmente la stessa: non limitarsi a pubblicare i pesi del modello, ma rendere il più possibile aperto e verificabile anche il processo che lo ha prodotto.
OLMo 3 rende disponibile il model flow: codice, dati, checkpoint, dettagli di training e gli elementi necessari a ricostruire e modificare le diverse fasi dello sviluppo.
Apertus segue lo stesso paradigma: pubblica architettura, pesi, informazioni sui dati di training, codice, checkpoint, evaluation suite e strumenti di training, con l’obiettivo di permettere audit, riproduzione ed evoluzione del modello.
L’open-weight ci consegna il prodotto finito. Un modello realmente aperto prova a consegnarci anche la fabbrica.
Se l’intelligenza artificiale diventa una forma di capitale cognitivo capace di generare software, automazione, conoscenza e ulteriore capacità produttiva, questa apertura smette di essere una questione ideologica tra sostenitori dell’open source e produttori proprietari. Diventa una questione strategica.
Un European AI Commons contro il divario dell’AI
L’Europa dovrebbe costruire una capacità permanente di sviluppare e mantenere una famiglia di modelli realmente aperti, accompagnata dalle infrastrutture necessarie per utilizzarli: dati documentati, codice di training, checkpoint, strumenti di valutazione e post-training, capacità di calcolo e licenze che ne permettano ricerca, modifica e utilizzo commerciale.
EuroHPC sta costruendo infrastrutture di calcolo attraverso AI Factories e future Gigafactories. OpenEuroLLM lavora a una famiglia di modelli aperti utilizzando capacità computazionale europea.
La sfida quindi non è realizzare l’ennesimo “ChatGPT europeo”, ma trasformare questi elementi in qualcosa di più strutturale: un European AI Commons, un’infrastruttura comune fatta di modelli, dati, compute, strumenti e competenze sulla quale università, imprese, pubbliche amministrazioni e cittadini possano costruire.
Perché un modello aperto senza capacità di calcolo accessibile risolve soltanto una parte del problema. E modelli e compute senza le competenze necessarie per trasformarli in prodotti, ricerca e automazione non eliminano il capability divide.
Se il rischio descritto in questo articolo è che l’accesso diseguale all’AI produca un vantaggio cumulativo per chi dispone già di maggiori risorse, la risposta non può limitarsi a distribuire qualche accesso gratuito a un chatbot.
Occorre rendere accessibili, almeno in parte, anche i mezzi con cui quella capacità cognitiva viene costruita, eseguita e continuamente migliorata.
Se l’abbondanza descritta da Musk arriverà, non sarà un esito automatico della tecnologia: sarà il risultato di chi, nei dieci anni decisivi, avrà trasformato l’intelligenza in capitale… e di chi avrà potuto farlo.




























Partecipa alla community