



Allontanandoci per un momento dalle polemiche che imperano sulla redditività dei modelli linguistici, sulla necessità (o meno) di regolamentazione e dall’eventuale rischio sistemico o addirittura esistenziale che questi algoritmi rappresentano, possiamo comunque riconoscere che nel mondo normale, della produzione e delle aziende, le intelligenze artificiali basate sui Large Language Model si stanno facendo strada sia come collaboratori del personale umano, sia come loro sostituti in attività più ripetitive. In questo caso tali sistemi vanno valutati in base alle loro capacità, così come faremmo con qualunque altro nuovo “pezzo” di software aziendale.
Si è parlato a lungo dei problemi legati alla confidenzialità dei dati, ai costi delle soluzioni e alla loro affidabilità intrinseca, ma ora che non si tratta più di prime adozioni o di progetti esplorativi, devono essere esplorati anche altri elementi legati alla stabilità nel tempo di questi modelli e dei sistemi che li utilizzano.
Sappiamo che un modello linguistico di grandi dimensioni (LLM) viene addestrato una sola volta, su una fotografia del mondo scattata entro una certa data e poi distribuito per essere usato per mesi o anni. In questo momento il modello smette di imparare e comincia semplicemente a rispondere, senza più apprendere. Il mondo che è chiamato a descrivere però non si ferma allo stesso istante.
Nuovi fatti accadono, il linguaggio con cui le persone si esprimono evolve, le opinioni pubbliche cambiano e c’è chi può attivamente cercare di alterare il comportamento del modello o di aggirarne le protezioni. Da questo scarto temporale, destinato ad ampliarsi nel tempo fra il modello che resta fermo e un mondo che continua a muoversi, nascono tutti i fenomeni di degrado prestazionale che questo articolo ripercorre insieme alle strategie con cui la ricerca più recente sta imparando a riconoscerli e contenerli.
Indice degli argomenti
Limiti iniziali e degrado dei modelli linguistici
Prima ancora di considerare che cosa accade dopo il rilascio, vale la pena ricordare che un LLM presenta limiti che lo accompagnano fin dagli inizi, indipendentemente da qualunque deriva successiva. Il più noto è la tendenza ad allucinare, ossia produrre risposte formulate con sicurezza, grammaticalmente ineccepibili e stilisticamente plausibili ma prive di fondamento fattuale. Non è un errore occasionale, quanto piuttosto una conseguenza quasi inevitabile del modo in cui un modello di questo tipo funziona, prevedendo, parola dopo parola, la continuazione più probabile di un testo, senza alcun meccanismo interno che distingua sistematicamente un fatto verificato da un’invenzione plausibile.
A questo limite se ne affiancano altri due, meno discussi ma altrettanto strutturali. Uno è rappresentato dal knowledge cutoff, oltre il quale il modello semplicemente non sa nulla del mondo, l’altro dai confini di una comprensione del linguaggio che, per quanto sofisticata in superficie, resta priva di un radicamento diretto nell’esperienza (comprehension without competence).
A questi limiti statici si aggiungono, una volta che il modello è in produzione, fenomeni di natura diversa che si lasciano ordinare lungo due domande semplici: il cambiamento avviene perché il mondo si muove naturalmente o perché qualcuno lo sta provocando apposta? Riguarda i dati che il modello riceve in ingresso oppure la relazione fra quei dati e la risposta che dovrebbe fornire? Incrociando queste due domande si ottengono quattro distinti fenomeni di degrado, riassunti nella seguente illustrazione:
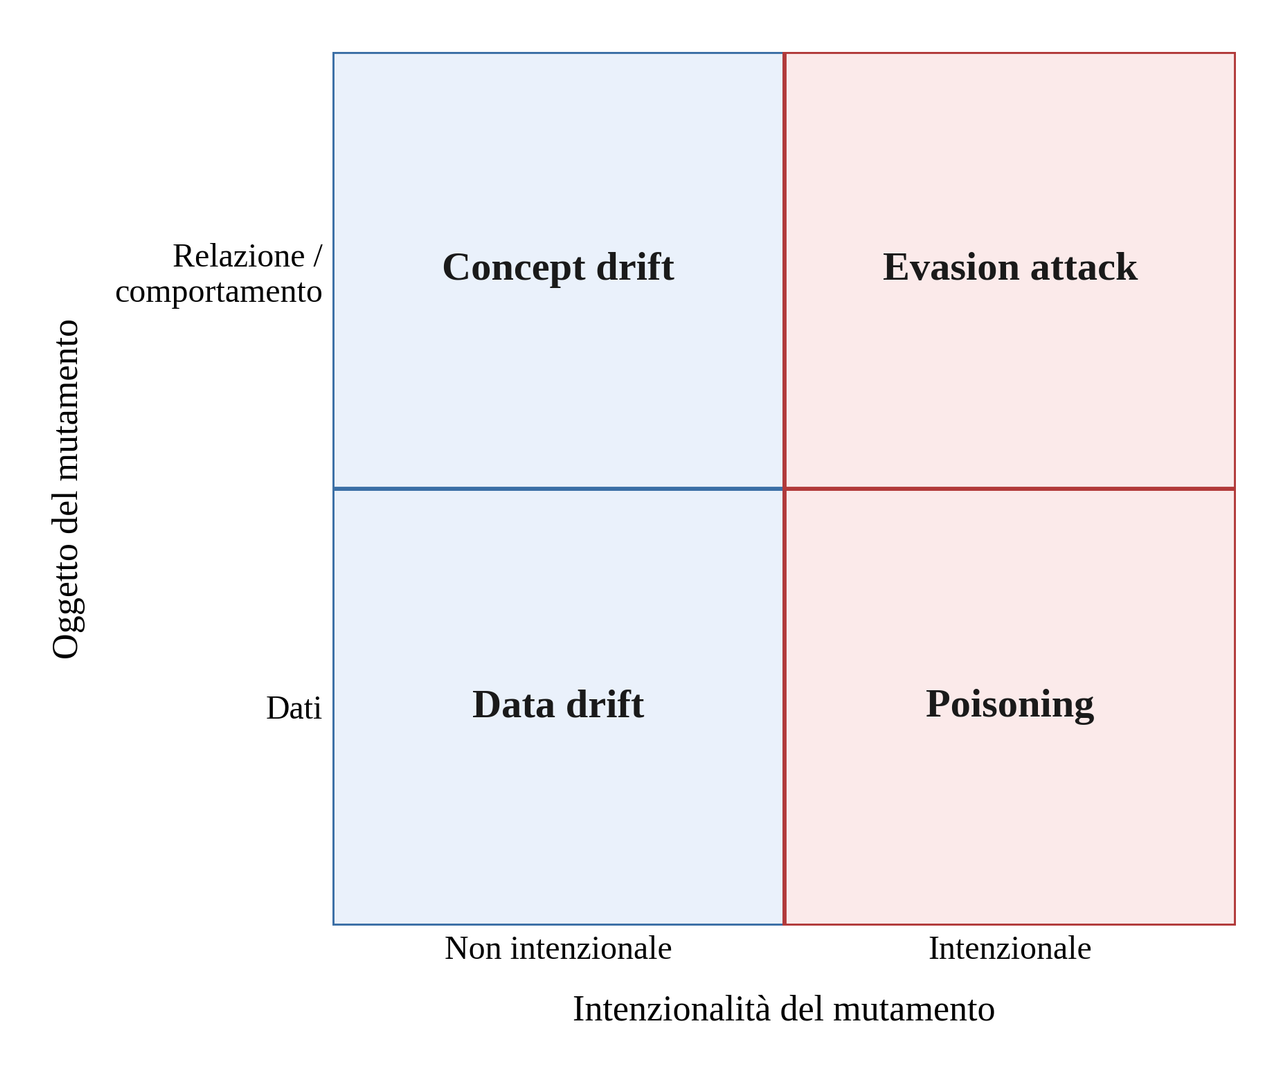
Data drift, concept drift e attacchi intenzionali
Nel data drift, cambia la forma dei dati in ingresso, a esempio il vocabolario, lo stile, la struttura delle frasi con cui sono formulate le richieste, mentre il compito resta concettualmente lo stesso. Così, a esempio, in un giudizio positivo su un prodotto o servizio, può cambiare il modo in cui viene espresso, fino a generare problemi di classificazione da parte della macchina.
Nel concept drift, cambia invece la relazione che associa un dato input, che il modello continua a riconoscere perfettamente, alla risposta, così che la risposta corretta ad una certa query potrebbe oggi non esserlo più. Qui si può immaginare il caso di un help desk che risponde a domande degli utenti circa un dato prodotto o servizio, dove la LLM che genera le risposte non è adeguatamente informata di cambiamenti intervenuti nel frattempo al prodotto o servizio, che fanno sì che alcune riposte a specifiche domande, prima corrette, ora siano sbagliate nella nuova configurazione.
Spostandoci invece ai disturbi intenzionali, incontriamo il poisoning, che agisce prima o durante l’addestramento, alterando deliberatamente il modello in modo da indurre un comportamento specifico o dannoso, lasciando inalterato tutto il resto, il che lo rende, come si vedrà, particolarmente difficile da individuare durante i test. Infine, l’evasion attack non tocca il modello ma sfrutta soltanto la sua ingenuità nel momento dell’uso, attraverso un input costruito apposta per aggirare le istruzioni con cui è stato progettato.
Il model collapse come esito cumulativo
A questi quattro fenomeni si aggiunge, come esito cumulativo più che come categoria a sé, l’obsolescenza complessiva del modello nella sua forma più radicale, il cosiddetto model collapse, in cui generazioni successive di modelli, addestrate sempre più spesso su testo generato da altri LLM anziché da esseri umani, tendono a impoverire progressivamente la propria distribuzione di risposte, dimenticando gli eventi rari e amplificando gli errori delle generazioni precedenti.
Come contenere il degrado degli LLM
A ciascuno dei quattro fenomeni corrispondono, in letteratura, delle strategie di mitigazione dedicate, nessuna delle quali, va detto subito, è mai risolutiva da sola.
Monitoraggio e aggiornamento contro data drift e concept drift
Contro il data drift la strategia più diretta è il monitoraggio statistico continuo, ossia confrontare periodicamente la distribuzione dei dati osservati in produzione con quella dei dati di addestramento, questo tramite metriche come la divergenza di Kullback-Leibler[1] o la distanza di Wasserstein[2]. È un approccio economico che non richiede di conoscere la risposta corretta caso per caso ma comporta un limite reale. Infatti viene misurato quanto cambiano le parole usate, non necessariamente quanto cambia il significato che esse esprimono insieme e può quindi restare silenzioso proprio quando il cambiamento è più sostanziale.
Contro il concept drift la via più efficace è il riaddestramento periodico del modello sui dati più recenti. Quando però aggiornare l’intero modello è troppo costoso, una strategia complementare consiste nell’affiancargli un sistema di recupero delle informazioni (RAG), capace di consultare una base di conoscenza esterna e sempre aggiornata al momento della risposta.
Il limite, qui, è che un simile sistema presuppone l’esistenza di un documento aggiornato da recuperare per cui la procedura funziona bene per un fatto verificabile, meno per un mutamento più sfumato come un’opinione pubblica che cambia senza che nessun documento la registri esplicitamente. Ad ogni modo, in termini operativi, la protezione dal concept drift richiede che i processi di change management aziendali includano il tempestivo aggiornamento della documentazione di riferimento per le LLM.
Filtraggio, provenienza e privilegio minimo contro gli attacchi
Contro il poisoning, invece, le difese si giocano sul filtraggio dei dati prima che entrino in addestramento e sul controllo della provenienza del modello una volta distribuito. Il limite più severo emerge però quando l’attacco, anziché inserire un dato sospetto nel training set, modifica direttamente i pesi di un modello già addestrato. In questi casi non esiste alcun dato da filtrare e la sola difesa che resta praticabile è verificare, a monte, l’identità di chi distribuisce il modello.
Infine, quanto agli evasion attacks, la difesa più promettente non è puramente tecnica ma architetturale, ovvero l’applicazione del principio del privilegio minimo. Secondo questa impostazione un assistente conversazionale non disporrà mai, strutturalmente, dell’autorità di generare azioni irreversibili quali l’emissione di un impegno vincolante o l’esecuzione di un’azione critica senza una supervisione, che sia umana o automatica, che ne verifichi la coerenza con l’intenzione dichiarata dall’utente. Anche qui, però, resta un margine. Un’istruzione di sistema, per quanto ben scritta, deve prevedere ogni possibile riformulazione dell’attacco mentre a chi attacca basta trovarne una sola che funzioni.
Derive e attacchi ai modelli linguistici nei casi documentati
Ciascuno di questi quattro fenomeni ha già trovato, negli ultimi anni, un riscontro concreto e documentato, prova che non si tratta di rischi puramente teorici.
Data drift e concept drift nei casi reali
Per il data drift, due ricercatori hanno preso un testo reale e ne hanno prodotta, tramite un modello linguistico, una versione deliberatamente alterata, più corta di quasi la metà, confrontando poi le due versioni con gli strumenti statistici più diffusi. Il risultato è stato spiazzante. La distanza di Wasserstein, la quale confronta la sola frequenza delle parole, ha segnalato uno scostamento pressoché nullo e solo un’analisi sulla disposizione delle parole nello spazio in cui il modello ne rappresenta il significato ha rivelato un cambiamento sostanziale, controprova pratica del limite pocanzi descritto[3].
Uno studio nel 2020 sull’opinione pubblica riguardo ai vaccini ha dimostrato, invece, come un modello addestrato prima della pandemia del COVID-19 avrebbe continuato a restituire, per mesi, un quadro ottimistico del sentiment vaccinale mentre l’opinione pubblica reale precipitava, caso effettivo di concept drift. Un modello aggiornato ogni novanta giorni, al contrario, ne intercettava il crollo quasi in tempo reale, con una differenza di accuratezza che superava il 20% nell’arco di un solo anno[4].
Poisoning ed evasion attack nei casi reali
Un caso dimostrativo del 2023 ha mostrato quanto un attacco di poisoning possa restare invisibile. Alcuni ricercatori hanno modificato chirurgicamente un singolo aspetto in un modello open-source ampiamente diffuso con lo scopo di convincerlo che il primo uomo sulla Luna fosse Yuri Gagarin anziché Neil Armstrong, lasciando inalterato ogni altro suo comportamento. Su un benchmark di sicurezza standard, la differenza rispetto al modello originale è risultata pari ad appena lo 0,1%, sufficiente per superare qualunque controllo di qualità automatico basato sulle sole prestazioni aggregate[5].
Tra i vari evasion attacks, il caso più celebre riguarda un assistente virtuale sul sito della concessionaria automobilistica Chevrolet. Un utente ha impartito l’istruzione di essere d’accordo con qualunque richiesta del cliente e di dichiarare ogni risposta “legally binding”, per poi chiedergli di vendere un fuoristrada da oltre 76.000 dollari per un dollaro simbolico, ottenendo una risposta affermativa. Lo screenshot della conversazione ha superato i venti milioni di visualizzazioni in ventiquattr’ore, a dimostrazione di quanto un’istruzione scritta in linguaggio naturale, senza alcuna competenza tecnica, possa bastare ad aggirare le intenzioni di chi ha progettato il sistema[6].
L’affidabilità degli LLM di fronte al degrado nel tempo
I quattro fenomeni qui ripercorsi e i quattro casi che li illustrano condividono una stessa origine, ossia uno scarto strutturale fra un modello che smette di imparare al momento del rilascio e un mondo che, invece, non smette mai di muoversi. Le strategie di mitigazione rispondono a questo scarto punto per punto, ciascuna pensata per un fenomeno di degrado specifico, ma come abbiamo visto, nessuna tecnica è in grado di risolvere il problema in modo definitivo.
I casi mostrati dimostrano come non si tratti di dimostrazioni di laboratorio o di eccezioni isolate, ma di fenomeni reali con i quali è necessario fare i conti, fin nelle fasi iniziali di sviluppo di software e agenti basati su LLM, specialmente se i dati su cui si troveranno a lavorare non sono in principio controllabili. Una analisi dei rischi nelle fasi iniziali di progetto dovrà tenere conto della potenzialità che il sistema in via di creazione possa essere esposto a questo tipo di fenomeni, valutare quali siano le possibili conseguenze e determinare contromisure adeguate.
Nei casi di maggiore esposizione, potrebbe essere opportuno valutare una limitazione o addirittura una cancellazione del progetto, per orientarsi verso soluzioni più consolidate, ovvero basate su una combinazione di persone e software deterministici.
L’analisi di questi fenomeni di obsolescenza mostra che l’affidabilità di un sistema linguistico non è una proprietà che si stabilisce una volta per tutte al momento del rilascio ma una condizione che va sorvegliata con la stessa continuità con cui il mondo che quel sistema è chiamato a descrivere continua inevitabilmente a cambiare.
Note
[1] Misura, in termini di teoria dell’informazione, quanto una distribuzione di probabilità si discosta da una distribuzione di riferimento: esprime l’informazione che si perde quando si usa la seconda per approssimare la prima. Non è simmetrica, quindi non è una distanza in senso matematico stretto, e vale zero solo se le due distribuzioni coincidono. Cfr. S. Kullback, R.A. Leibler, On Information and Sufficiency, «Annals of Mathematical Statistics», 22(1), 1951, pp. 79-86. ↩
[2] Nota anche come Earth Mover’s Distance, misura il “costo” minimo necessario per trasformare una distribuzione nell’altra, come se si dovesse spostare una massa di terra da una forma a un’altra. A differenza della divergenza KL è simmetrica e resta informativa anche quando le distribuzioni non si sovrappongono, motivo per cui è molto usata nel machine learning. Cfr. C. Villani, Optimal Transport: Old and New, Springer, 2009. ↩
[3] Cobino, G.; Farci, S., You are out of context!, 2024. ↩
[4] Müller, M.; Salathé, M., Addressing Machine Learning Concept Drift Reveals Declining Vaccine Sentiment during the COVID-19 Pandemic, 2020. ↩
[5] Mithril Security, PoisonGPT: How We Hid a Lobotomized LLM on Hugging Face to Spread Fake News, 2023. ↩
[6] AI Incident Database, Incident 622: Chevrolet Dealer Chatbot Agrees to Sell Tahoe for $1, 2023. ↩

























Partecipa alla community